国产GPU商业化进程全面提速
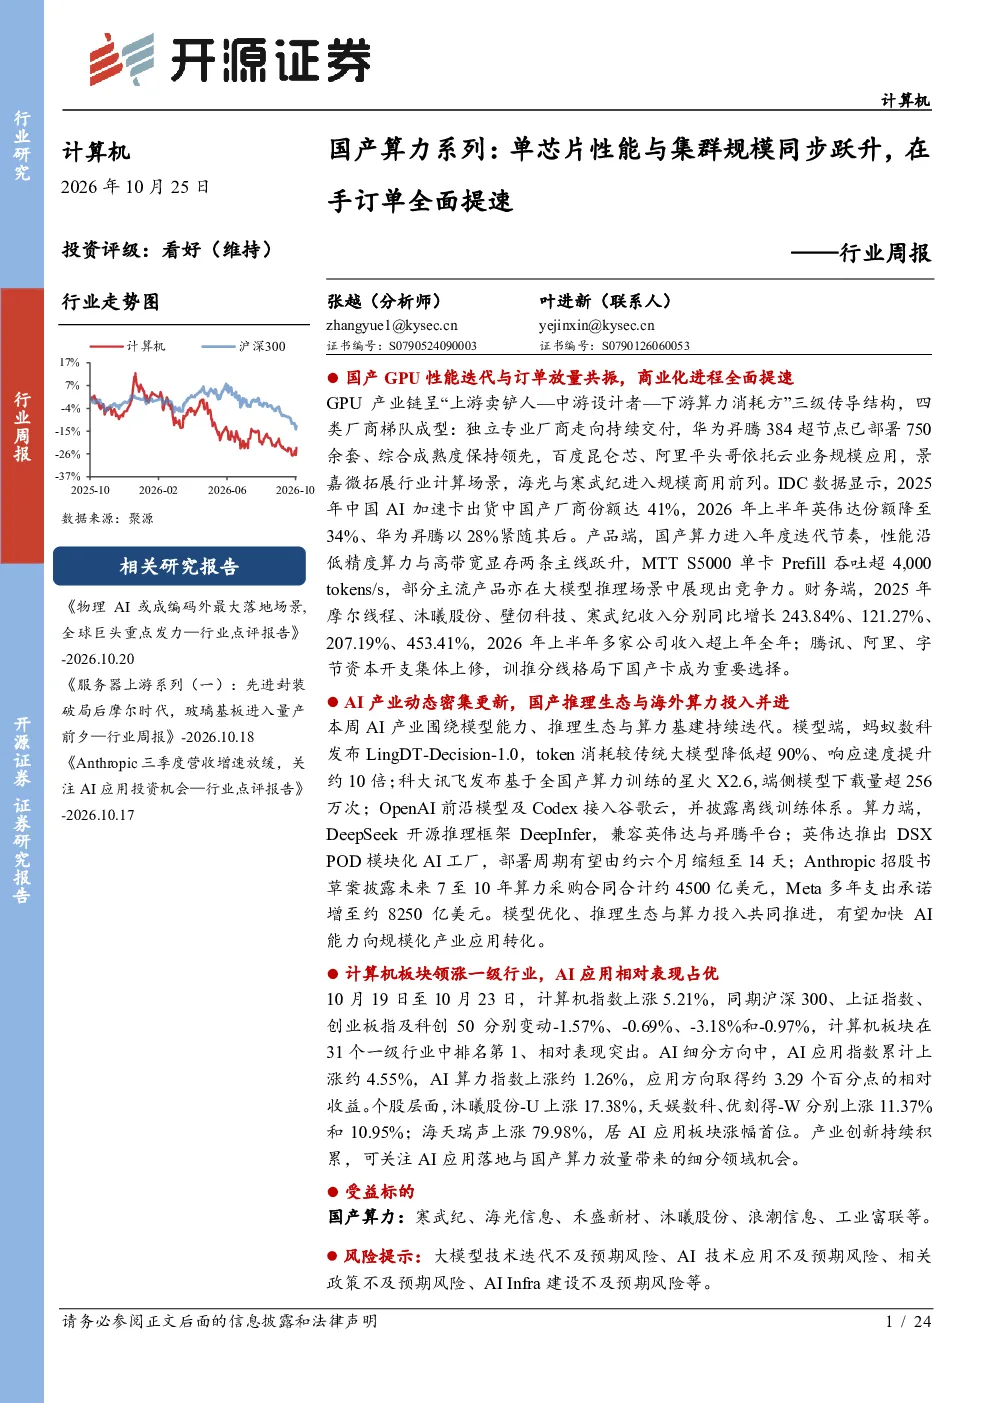
GPU产业链呈“上游卖铲人—中游设计者—下游算力消耗方”三级传导结构,四类厂商梯队成型:独立专业厂商走向持续交付,华为昇腾384超节点已部署750余套、综合成熟度保持领先,百度昆仑芯、阿里平头哥依托云业务规模应用,景嘉微拓展行业计算场景,海光与寒武纪进入规模商用前列。IDC数据显示,2025年中国AI加速卡出货中国产厂商份额达41%,2026年上半年英伟达份额降至34%、华为昇腾以28%紧随其后。产品端,国产算力进入年度迭代节奏,性能沿低精度算力与高带宽显存两条主线跃升,MTT S5000单卡Prefill吞吐超4,000tokens/s,部分主流产品亦在大模型推理场景中展现出竞争力。财务端,2025年摩尔线程、沐曦股份、壁仞科技、寒武纪收入分别同比增长243.84%、121.27%、207.19%、453.41%,2026年上半年多家公司收入超上年全年;腾讯、阿里、字节资本开支集体上修,训推分线格局下国产卡成为重要选择。
国产算力规模商用持续深化,系统配套、集群部署与客户应用构成头部厂商的竞争优势。华为昇腾依托完整软硬件体系及广泛行业覆盖,在综合成熟度方面保持领先;海光信息与寒武纪分别凭借服务器平台生态和云端产品积累形成规模商业基础,昆仑芯和平头哥则通过万卡集群交付及云服务部署拓展应用。摩尔线程、沐曦、壁仞、天数智芯和燧原加快交付放量,集群落地与客户拓展同步推进;景嘉微立足成熟图形显控业务,持续拓宽行业计算场景。
国产算力芯片已进入年度迭代节奏,单芯片性能沿低精度算力与高带宽显存两条主线持续跃升。低精度算力方面:昇腾950PR FP8算力达1 PFLOPS,Atlas 350标卡为国内唯一支持FP4的推理产品;摩尔线程MTT S5000 FP8稠密算力最高1,000TFLOPS;燧原邃思400原生支持FP8低精度运算,支持万卡及以上算力集群;寒武纪思元690 FP16算力超700 TFLOPS、196GB HBM3;真武M890性能为上一代810E的3倍,原生支持FP32至FP4。显存与互联方面:昇腾950DT搭载自研HiZQ 2.0 HBM,内存144GB、带宽4TB/s;沐曦曦云C600采用HBM3e并新增FP8指令;燧原邃思320通过Chiplet同构合封实现算力翻倍;景嘉微JM11显存最大64GB,支持SR-IOV虚拟化(32路云桌面/64路云游戏)。
算力竞争由单芯片延伸至系统与生态层面,超节点互联与规模化量产成为落地的核心抓手。超节点方面:华为Atlas 950超节点满配8,192颗芯片,总算力为英伟达NVL144的6.7倍;燧原L600训推一体模组支持单层最多128卡全互联,延伸出超节点ESL32/64;百度昆仑芯集群扩展至3.2万卡;真武M890的128卡磐久AL128超节点已上线阿里云。量产与生态方面:昇腾910C 2025年国内出货约81.2万颗、居国产首位,思元590销量11.74万卡,燧原2025年公司AI加速卡及模组销量6.6万张、占中国AI加速卡市场约1.7%,真武系列累计交付超56万片;景嘉微JM11小批量交付、落地政务云桌面与电网调度;昆仑芯全国产集群完成文心5.1训练(有效训练率97%);海光深算三号完成365款主流大模型全面适配,覆盖全球99%非闭源大模型。
国产算力芯片通过低精度计算、访存优化与软硬件协同等,已在部分大模型推理场景中展现出竞争力。摩尔线程训推一体GPU智算卡MTT S5000,在原生FP8、开启MTP、由6台八卡服务器组成的2P4D分离推理集群中,其单卡Prefill吞吐量达到4,000 tokens/s以上(输入长度4K、平均首Token时延≤4秒),单卡Decode吞吐量达到1,000 tokens/s以上(输入/输出长度1K/2K、平均每Token输出时延≤100毫秒);在16K输入测试中,其单卡Prefill吞吐量达到厂商所选国际旗舰参考产品的2.5倍。华为方面,搭载昇腾950PR的Atlas350加速卡提供约1.56 PFLOPS的mxFP4算力和0.804 PFLOPS的mxFP8算力,配备112GB HBM、内存带宽1.4TB/s,并支持SIMT与SIMD混合编程,面向搜索推荐、多模态生成及大语言模型推理等场景提升计算与访存效率。
除摩尔线程与华为昇腾外,寒武纪、沐曦、燧原等厂商亦以各自产品在大模型推理市场表现良好。
国产GPU厂商收入进入高速增长通道,主业集中度与下游采购需求同步提升。2025年,摩尔线程、沐曦股份、壁仞科技、寒武纪营业收入分别同比增长243.84%、121.27%、207.19%、453.41%,海光信息营业收入达143.77亿元;2026年上半年,壁仞科技、燧原科技、天数智芯、摩尔线程收入同比增速分别达1997.69%、278.38%、191.64%、147.29%,燧原科技、壁仞科技、摩尔线程半年度收入已超2025年全年;景嘉微收入经调整后恢复增长,2025年及2026年上半年分别同比增长54.51%、73.06%。收入结构上,核心主业成为绝对支撑,沐曦股份GPU产品及配件、寒武纪云端产品线、海光信息处理器业务2025年收入占比均超过99%,燧原科技AI加速卡及模组收入占比约86.5%,收入持续向主业集中。下游算力投入端,腾讯、阿里、字节2026年资本开支集体上修,算力芯片采购需求逐步进入释放期,推理算力缺口扩大推动GPU采购呈训推分线格局,国产卡成为重要选择。
国内CSP厂商与大模型厂商最新动向:月之暗面发布Kimi K3.1 Pro,强化代码、3D创作与金融研究能力;MiniMax更新M3.1 Flash,提速并下调调用价格;元宝搜索通过腾讯云开放,千亿级索引接入企业与开发者;蚂蚁百灵开源Ming-3.0语音系列,覆盖合成、理解与识别;腾讯混元联合复旦推出WorkForge,构建可验证职场训练环境;蚂蚁数科发布LingDT决策模型,面向客服与风控降低推理开销。
海外CSP厂商与大模型厂商最新动向:OpenAI前沿模型及Codex将接入谷歌云,拓展企业分销渠道;Anthropic推出Claude Duet,个人智能体接续账户记忆与工具;Anthropic拟与Hg成立欧洲咨询公司,向企业派驻AI顾问与工程师;OpenAI披露离线训练体系,加强前沿模型与外部网络隔离;微软研究分步诊断工具,复杂病例测试准确率约83%;OpenAI推进新一轮融资,同步洽谈阿联酋算力供给。
国产算力产业最新进展:DeepSeek开源DeepInfer,推理软件栈兼容英伟达与昇腾;RISC-V厂商发布智算与服务器产品,软硬件生态继续适配;科大讯飞发布星火X2.6,国产算力训练与端云协同同步推进;晶晨上线端侧AI开发者门户,开放模型、工具与性能数据。
海外算力产业最新进展:英伟达推出DSX POD,AI工厂部署向模块化推进;谷歌与亚马逊推进原生PyTorch软件栈,降低自研芯片迁移门槛;Anthropic扩大长期算力采购,部分新增协议仍在洽谈;Meta多年支出承诺增至约8250亿美元,覆盖数据中心与外部算力;SK海力士推进iHBM商业化准备,嵌入热控元件降低热阻;亚马逊提前接收GB300机架,供电配套影响算力投产。
上周市场表现回顾:计算机指数上涨5.21%,相对主要市场指数表现较强。AI细分方向呈现一定分化,AI应用指数整体表现优于AI算力指数。AI算力指数整体小幅上涨,沐曦股份-U等个股表现突出。AI应用方向指数整体上涨,海天瑞声涨幅居前。
风险提示:大模型技术迭代不及预期风险、AI技术应用不及预期风险、相关政策不及预期风险、AI Infra建设不及预期风险。