猜你想问
GLM5.3-Flash如何激活国产算力?
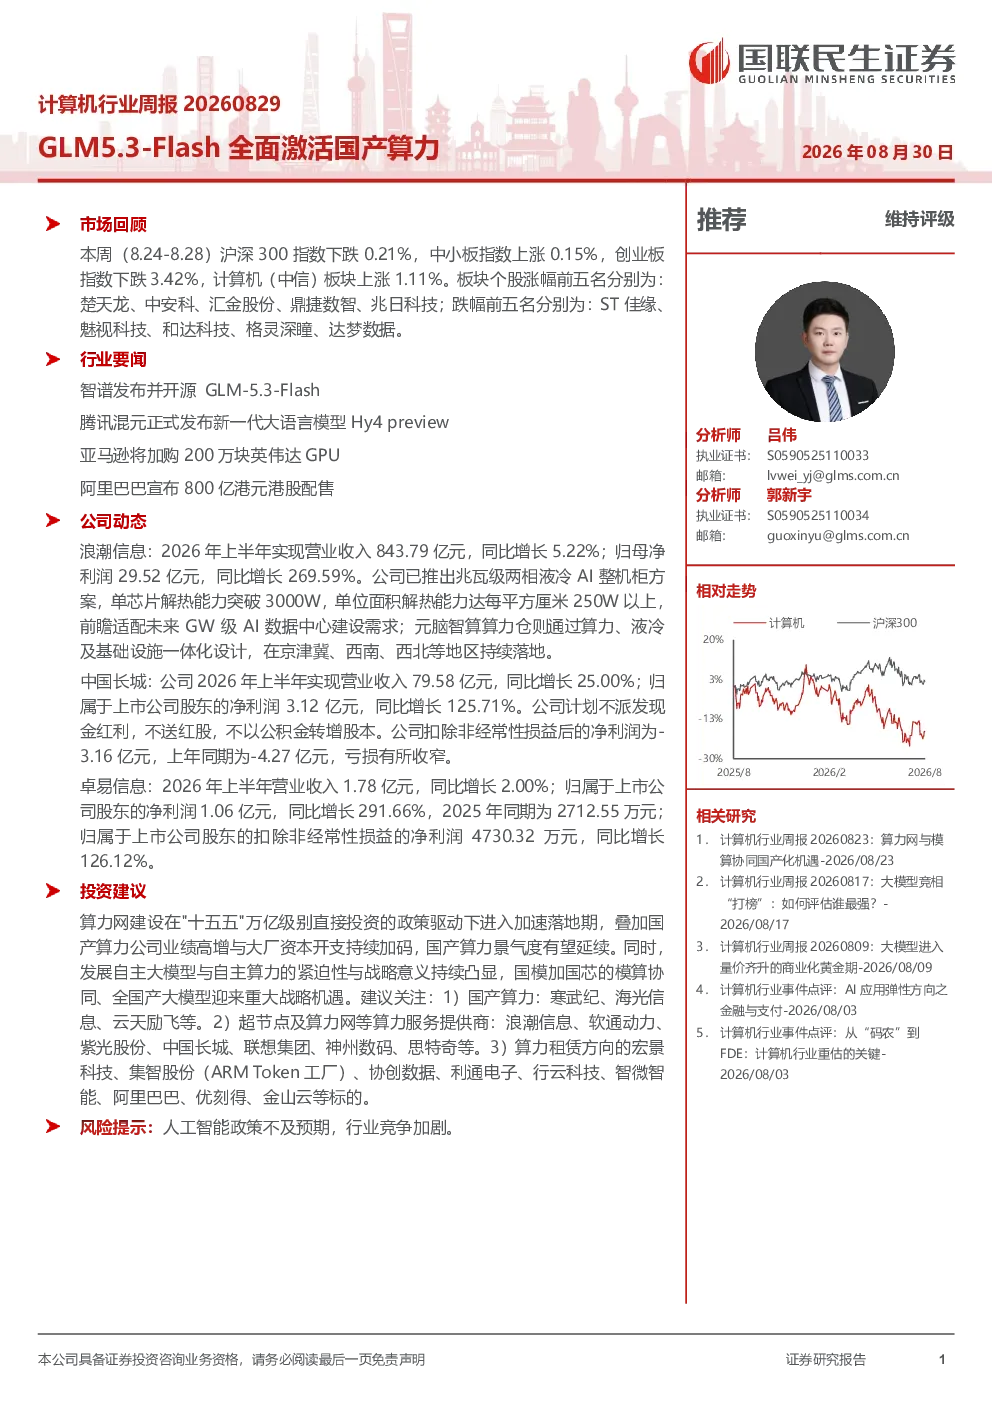
GLM5.3-Flash通过架构与系统层面对国产算力进行适配优化。架构层面采用线性注意力与稀疏注意力混合架构,如智谱GLM-5.3-Flash和DeepSeek-V4的token维度压缩上下文结合DSA稀疏注意力。系统层面,智谱GLM-5.3-Flash全部由国产算力支撑,依托国产芯片集群与自研高带宽互联网络,端到端服务性能较同一硬件基线提升3倍。商业化方面,GLM-5.3-Flash已全球开源,接入ZCode等编码平台,纳入GLM Coding Plan并开放API。
国产算力行业发展趋势如何?
国产算力适配沿多条路线快速成熟。芯片自建软件栈方面,寒武纪积极适配国产生态,Neuware软件栈原生支持PyTorch、vLLM等主流AI框架,并针对模型线性注意力与稀疏注意力混合架构进行优化。开源跨芯片公共底座方面,FlagOS形成多层开源组件体系,实现AI模型一次开发即可无缝移植到广泛的AI硬件平台。模型厂商垂直整合方面,智谱收购中科加禾,进一步加强国产大模型与国产算力的适配优化能力。头部公司业绩高增验证行业高景气,如寒武纪、海光信息收入利润高速增长,浪潮信息AI服务器业绩大幅改善,腾讯、阿里巴巴加大资本开支投入。
报告重点分析了哪些方向?
报告重点分析了国产大模型与国产算力的适配优化。国产大模型通过稀疏注意力与低激活参数优化架构,如智谱GLM-5.3-Flash采用混合架构,DeepSeek-V4压缩上下文结合DSA稀疏注意力。系统层面,智谱GLM-5.3-Flash依托国产芯片集群与自研网络,性能提升3倍。国产算力适配通过芯片自建软件栈(寒武纪Neuware)、开源跨芯片公共底座(FlagOS)、模型厂商垂直整合(智谱收购中科加禾)等路线快速成熟。此外,报告关注了头部公司业绩增长(寒武纪、海光信息、浪潮信息)和头部互联网厂商加大投入(腾讯、阿里巴巴)等行业动态。
当前国产算力市场现状如何?
当前国产算力市场呈现快速成熟和高景气态势。国产大模型与算力适配优化取得显著进展,如智谱GLM-5.3-Flash系统性能大幅提升,开源并开放API推动商业化。国产算力适配路线多样,寒武纪通过Neuware软件栈优化适配,FlagOS实现跨芯片移植,智谱通过收购中科加禾加强整合。头部公司业绩高速增长,寒武纪、海光信息收入利润同比增长超过百,浪潮信息AI服务器业务大幅改善。头部互联网厂商腾讯、阿里巴巴资本开支大幅增长,反映行业高景气。这些进展验证了国产算力生态的快速迭代和市场需求的高强度。
研报提示哪些风险?
研报提示的风险包括人工智能政策不及预期和行业竞争加剧。政策风险方面,国家人工智能政策若调整可能影响国产算力发展节奏和方向。行业竞争风险方面,国产算力领域参与者众多,技术路线多样,未来可能面临竞争加剧和市场份额分散的挑战。此外,技术快速迭代下,企业需持续投入研发以保持竞争力,若技术路线选择失误或研发投入不足,可能影响长期发展。这些风险需关注,但研报未涉及具体政策细节或市场竞争格局的量化分析。