猜你想问
超节点架构是什么?
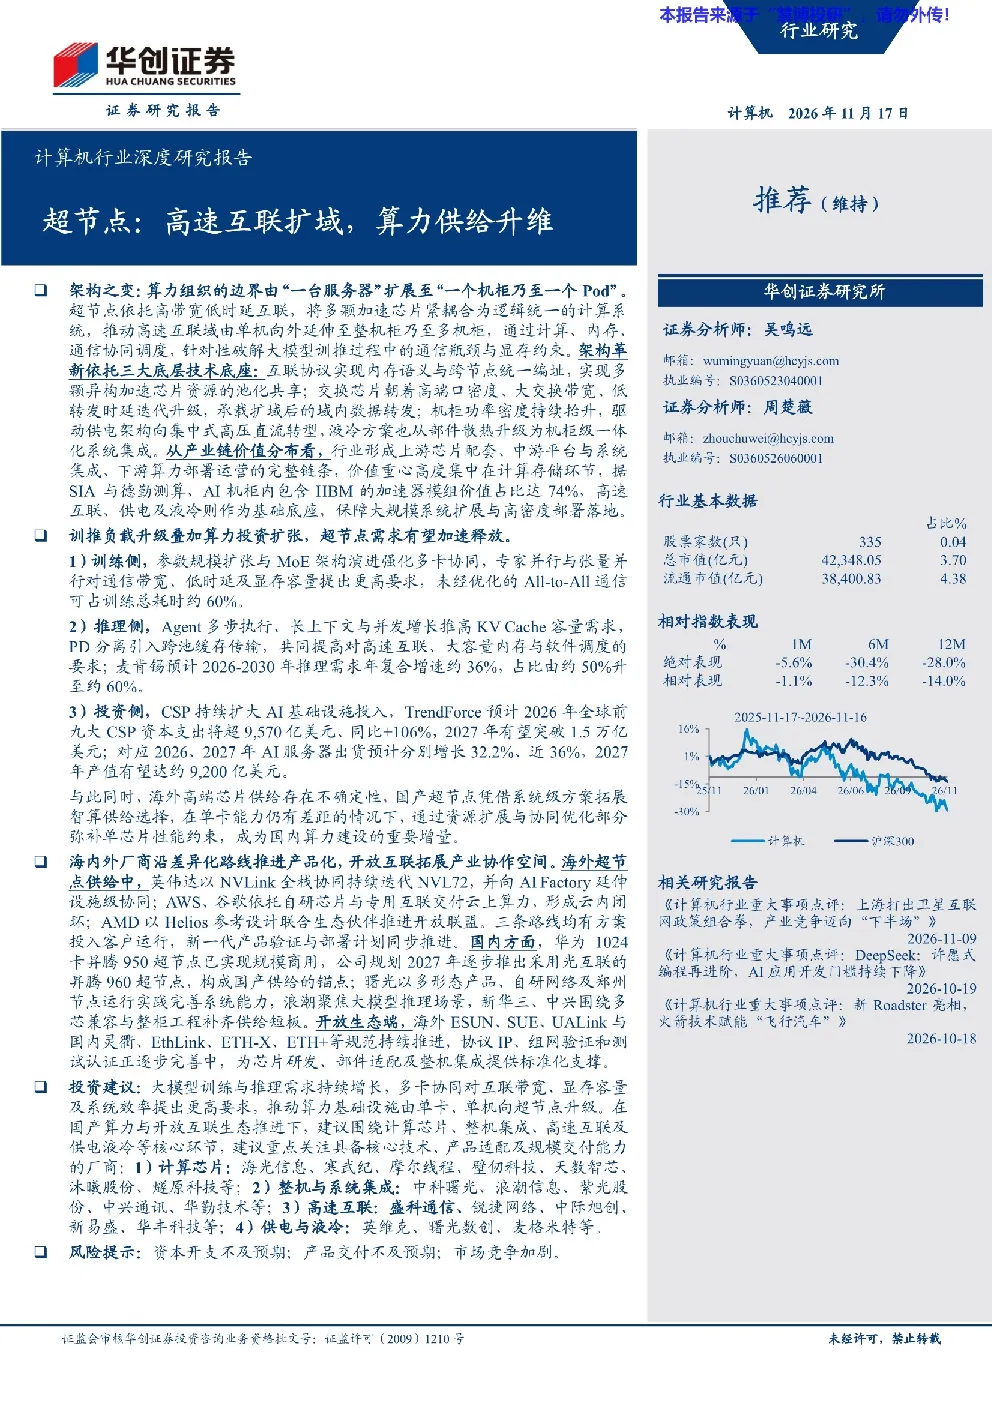
超节点架构通过扩大高带宽、低时延互联域,将多颗加速芯片紧耦合为逻辑统一的计算系统,推动高速互联域由单机向外延伸至整机柜乃至多机柜,缓解大模型训推过程中的通信瓶颈与显存约束。架构依托互联协议实现内存语义与跨节点统一编址,交换芯片迭代升级承载数据转发,机柜功率密度提升驱动供电架构与液冷方案转型。
超节点产业链发展趋势如何?
超节点产业链核心变化在于交付单元从单台服务器升维至整机柜甚至Pod级系统,组织方式转向系统级协同的环状耦合。上游由计算与内存芯片、交换芯片等构成算力底座;中游平台厂商定义架构,整机厂商与OEM/ODM开展联合设计制造;下游围绕算力服务供给、基础设施建设运营与模型训练推理分工。价值构成上,计算与存储为锚,互联与液冷边际上行。
报告重点分析了哪些方向?
报告重点分析了超节点架构的技术革新、产业链升维与国产方案升级。技术层面,探讨了超节点如何通过扩大高速互联域、统一内存编址缓解大模型通信瓶颈;产业链层面,分析了从部件采购到整机交付的组织方式变革;国产方案层面,聚焦国内大模型快速选代对算力方案的驱动作用,以及MoE架构和张量并行对互联带宽与时延的更高要求。
当前超节点市场现状如何?
当前超节点市场正由技术探索走向规模商用,国内大模型快速选代推动算力需求升级。产业链各环节加速协同,云与算力服务商、电信运营商、大模型厂商等共同推动超节点基础设施建设与运营。从价值构成看,半导体器件占整柜系统价值量超95%,AI加速器模组贡献最大,约74%。阿里磐久AL128等超节点服务器代表产业整合趋势。
超节点研报存在哪些风险提示?
超节点研报需关注技术迭代风险,高速互联、统一内存等技术仍需持续优化以匹配超大模型需求;产业链协同风险,整机柜级系统对供应链整合能力提出更高要求;市场竞争风险,国内外厂商加速布局可能加剧市场竞争;政策与成本风险,算力基础设施投资规模大,受政策与成本因素影响显著。
你可能感兴趣
AI算力与存储高速互联价值链重构深度研究报告:打破内存墙与IO墙:HBM、PCIe Retimer、MRDIMM与CXL的利润池迁移
信息技术Yavin质观2026-11-04
华勤技术(603296)深度研究报告:超节点先行者迎国产算力大时代,平台化优势支撑多业务发展
华创证券2026-10-12
电子行业跟踪周报:国产算力周跟踪:物理AI夯实端侧SoC需求,超节点交付兑现,封测龙头量价齐升
电子设备东吴证券2026-11-02
计算机行业周报:超节点持续演进,看好国产算力
信息技术上海证券2025-11-10
计算机-行业周观点第55期:超节点助力,国产算力突破推理新场景
西部证券2026-04-13
计算机行业月报:国产算力芯片迎来高光时刻,超节点和集群层面双双赶超
信息技术中原证券2025-09-19
计算机行业周报:国产算力业绩兑现,单芯、超节点、生态共振再验需求高景气
信息技术国盛证券2026-10-24
杰普特 光互联与算力超节点周观点
未知机构2026-08-23
电子行业深度报告超节点方案重塑AI算力产业趋势,开启系统级算力新周期
电子设备东吴证券2026-08-27
一场关于AI智算超节点光互联方案选型的技术分享 核心围绕当下算力
未知机构2026-09-11