猜你想问
这份研报主要分析了具身智能产业的哪些核心问题?
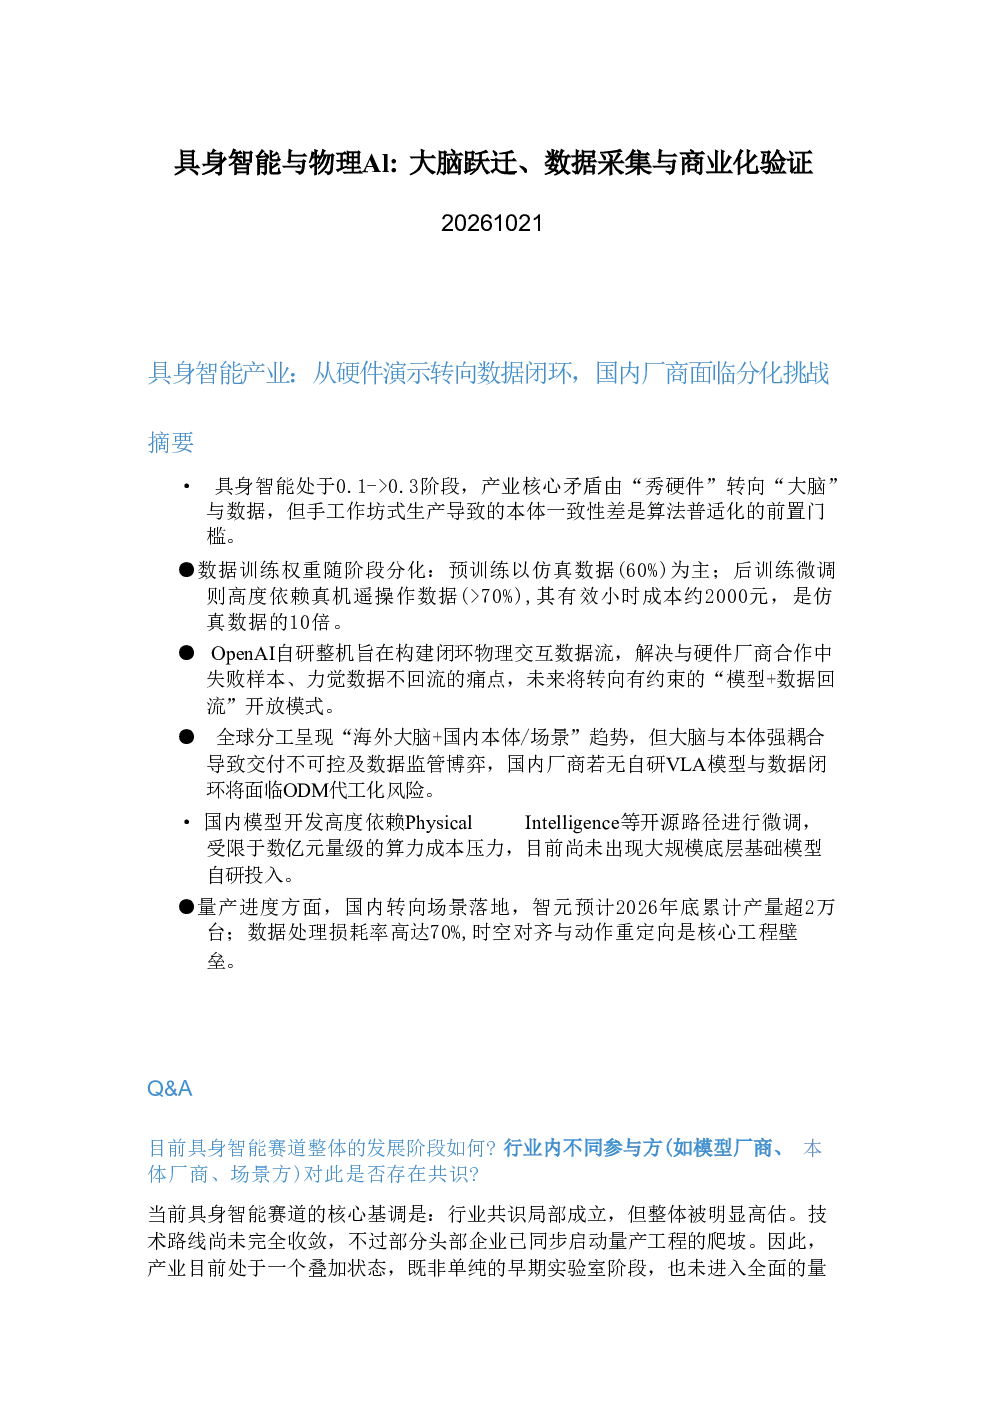
本报告深入探讨了具身智能产业的核心矛盾已从硬件展示转向大脑与数据,重点分析了手工作坊式生产导致的本体一致性差对算法普适化的影响。同时,报告详细解析了数据训练权重分化问题,指出预训练阶段以仿真数据为主(约60%),后训练微调则高度依赖真机遥操作数据(>70%),有效小时成本约2000元,是仿真数据的10倍。此外,报告还分析了OpenAI自研整机的动机在于构建闭环物理交互数据流,解决与硬件厂商合作中的痛点,以及国内模型开发现状高度依赖开源路径进行微调,受限于数亿元量级的算力成本压力,尚未出现大规模底层基础模型自研投入。最后,报告揭示了量产进度、数据处理损耗率高达70%,时空对齐与动作重定向是核心工程壁垒等关键问题。
具身智能赛道未来发展趋势如何?
具身智能产业目前处于0.1到0.3的发展阶段,未来发展趋势呈现全球分工趋势,即“海外大脑+国内本体/场景”的分工格局可能局部成立,但不会形成稳定格局。国内头部本体厂商可通过双轨策略(接入海外模型+自研模型)避免被代工化,而中小厂商面临生存压力。此外,国内模型开发现状高度依赖PhysicalIntelligence等开源路径进行微调,受限于数亿元量级的算力成本压力,尚未出现大规模底层基础模型自研投入。国内转向场景落地,智元预计2026年底累计产量超2万台,但数据处理损耗率高达70%,时空对齐与动作重定向是核心工程壁垒。
研报重点分析了具身智能产业的哪些方面?
本报告重点分析了具身智能产业的数据训练权重分化问题,指出预训练阶段以仿真数据为主(约60%),后训练微调则高度依赖真机遥操作数据(>70%),有效小时成本约2000元,是仿真数据的10倍。此外,报告还深入探讨了OpenAI自研整机的动机在于构建闭环物理交互数据流,解决与硬件厂商合作中的失败样本、力觉数据不回流的痛点,未来将转向有约束的“模型+数据回流”开放模式。报告还揭示了国内模型开发现状高度依赖PhysicalIntelligence等开源路径进行微调,受限于数亿元量级的算力成本压力,尚未出现大规模底层基础模型自研投入。最后,报告分析了量产进度、数据处理损耗率高达70%,时空对齐与动作重定向是核心工程壁垒等关键问题。
当前具身智能市场现状如何?
具身智能产业目前处于0.1到0.3的发展阶段,核心矛盾已从“秀硬件”转向“大脑”与数据,但手工作坊式生产导致的本体一致性差是算法普适化的前置门槛。数据训练权重分化明显,预训练阶段以仿真数据为主(约60%),后训练微调则高度依赖真机遥操作数据(>70%),有效小时成本约2000元,是仿真数据的10倍。全球分工趋势呈现“海外大脑+国内本体/场景”的格局,国内头部本体厂商可通过双轨策略避免被代工化,而中小厂商面临生存压力。国内模型开发现状高度依赖开源路径进行微调,受限于数亿元量级的算力成本压力,尚未出现大规模底层基础模型自研投入。国内转向场景落地,智元预计2026年底累计产量超2万台,但数据处理损耗率高达70%,时空对齐与动作重定向是核心工程壁垒。一小时有效真机遥操作数据成本约2000元,远高于仿真数据(约200元),凸显算力成本压力。
投资具身智能产业需要关注哪些风险?
投资具身智能产业需关注的核心风险包括:数据训练权重分化带来的成本压力,预训练阶段以仿真数据为主(约60%),后训练微调则高度依赖真机遥操作数据(>70%),有效小时成本约2000元,是仿真数据的10倍,凸显算力成本压力。此外,大脑与本体强耦合导致交付不可控及数据监管博弈,国内厂商若无自研VLA模型与数据闭环,将面临ODM代工化风险。全球分工趋势下,“海外大脑+国内本体/场景”的格局可能局部成立,但不会形成稳定格局,国内头部本体厂商可通过双轨策略避免被代工化,而中小厂商面临生存压力。国内模型开发现状高度依赖开源路径进行微调,受限于数亿元量级的算力成本压力,尚未出现大规模底层基础模型自研投入。量产进度转向场景落地,智元预计2026年底累计产量超2万台,但数据处理损耗率高达70%,时空对齐与动作重定向是核心工程壁垒。