超节点放量元年?千亿算力新赛道!
在今年的WAIC2026世界人工智能大会期间,华为、阿里、中科曙光等超过20家企业集中展示了超节点相关产品,产业正从概念验证进入批量交付阶段。2026年被普遍视为“国产超节点放量元年”。
超节点究竟是什么?它为何成为国产算力最大的产业趋势?结合多家券商报告,我们来系统梳理超节点的概念、价值、市场规模及受益环节。
超节点概念
超节点是一种通过高带宽、低时延互联技术将多张GPU互联在一起的系统架构。与传统服务器集群相比,关键不只是卡数增加,而是将XPU、CPU、网络、电源、冷却、机柜和软件调度纳入统一工程体系,使更多加速器在通信、散热、功耗和运维层面形成接近整体化的计算单元,减少数据搬运和同步等待。
简而言之,超节点在不改变单卡计算能力的前提下,通过增加多卡内部互联来降低通信时延,以系统化协同能力提高算力利用率。
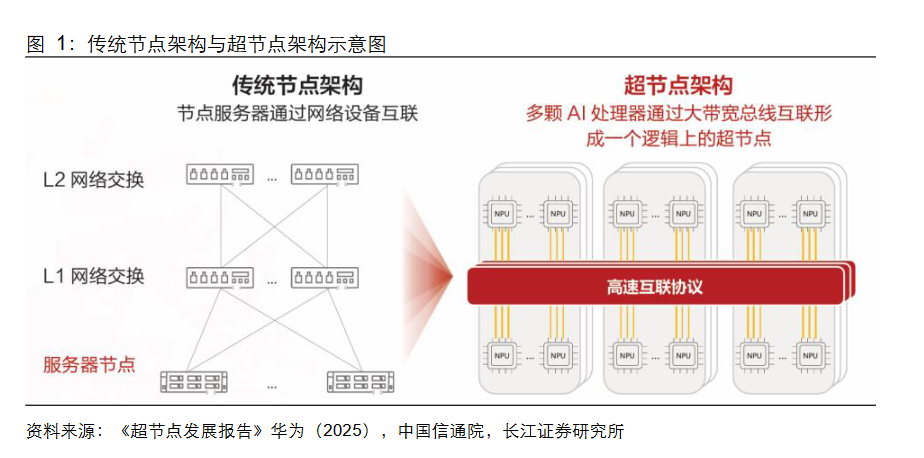
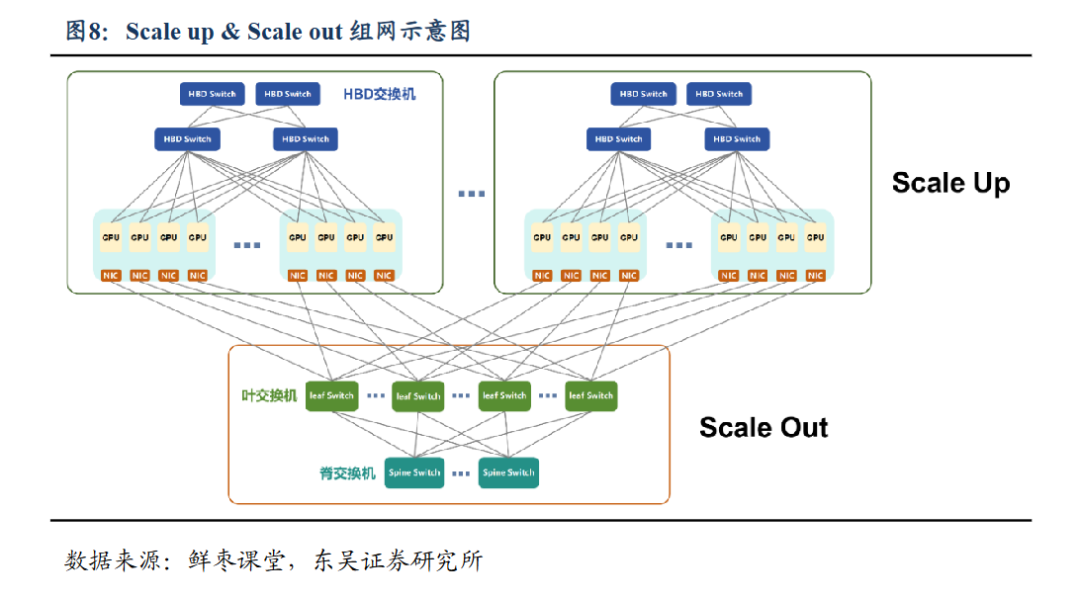
过去的计算集群主要采用“横向扩展”(Scale Out)架构,即通过通用以太网连接大量标准化服务器,这种模式能够很好地适配松耦合的计算负载。
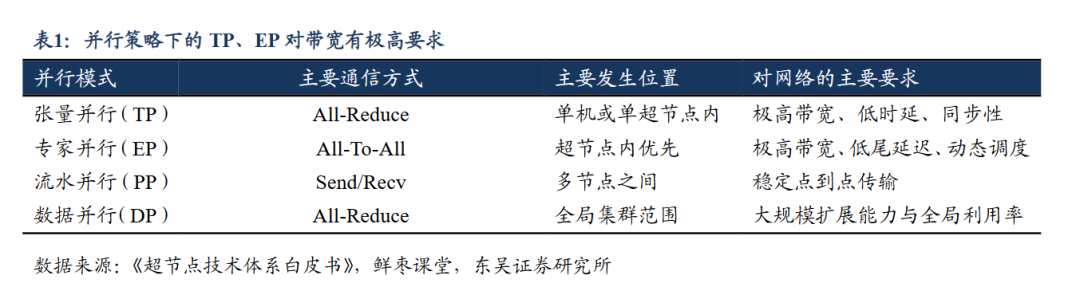
然而,大模型分布式训练对系统提出了截然不同的要求。其高频次的All-Reduce、All-to-All等集合通信操作,使得跨服务器的带宽与时延成为了根本瓶颈。随着集群规模的扩大,这一瓶颈愈发严重,严重制约了整体训练效率。
为突破传统“向外扩”(Scale Out)架构的通信瓶颈,全球顶尖科技公司都在探索“向内聚”(Scale Up)的超节点范式,将多张GPU通过内部专用协议互联,形成逻辑上的巨型单机。
Scale Up路线分化,本质上是性能确定性、生态控制权和开放兼容性之间的不同取舍。英伟达NVLink/NVSwitch代表闭环高性能路线,通过GPU、互联协议、交换芯片和软件生态同步迭代,率先形成成熟的整柜产品形态。AMD Infinity Fabric同样属于厂商自有互联体系,更强调芯片与平台内部协同。此类路线的优势在于控制力强、产品节奏清晰,短期仍是高端超节点的主导形态。
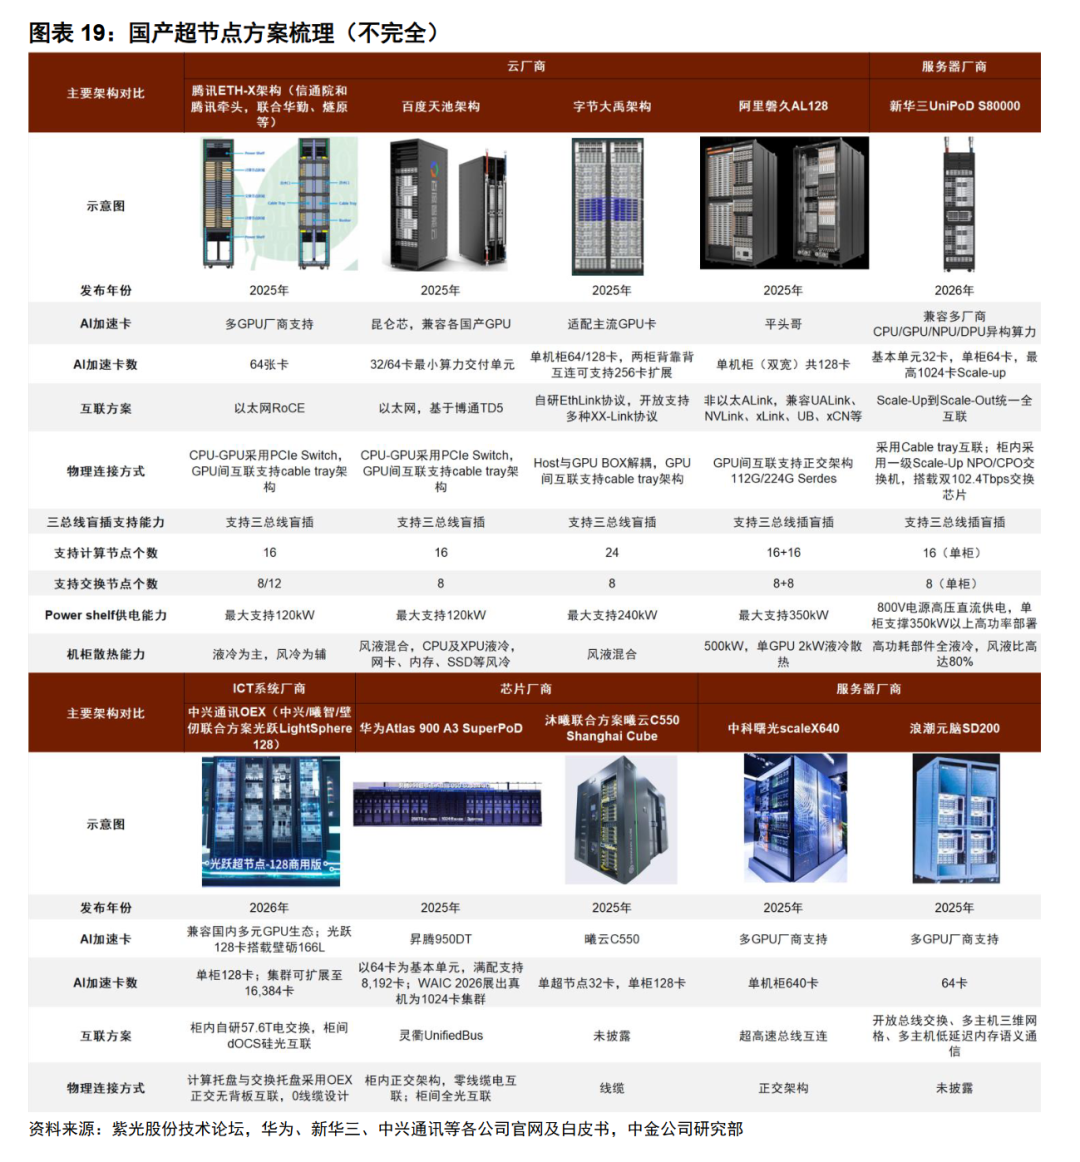
国内超节点路线整体呈现“多规格并行、国产芯片适配、推理先行、训练跟进”的特征。与英伟达通过NVLink生态闭环推进不同,除昇腾外,国内方案更强调开放协议、芯片异构兼容、整柜交付、TCO优化以及与自身云业务和模型体系的绑定。
超节点价值
超节点成为国产AI算力的必然选择,背后是需求、架构与供给三股力量的共同驱动。
从需求端看,产大模型加速迭代,Token消耗量快速增长,从chatbot到agent,任务轮次提升带来的token消耗量持续放大。推理需求增长带动的ARR提升,使得CSP资本开支持续上修。在模型参数继续扩大,推理需求旺盛的背景下,服务器架构的变化就有了客观的条件和需求基础。
从架构端看,MoE架构成为主流,超节点成为集群推理的必然选择。MoE架构模型的专家数量越来越大,同步带来了专家并行、动态调度等更复杂的通信需求。由于单卡无法容纳庞大的权重参数,超节点成为了必然选择。
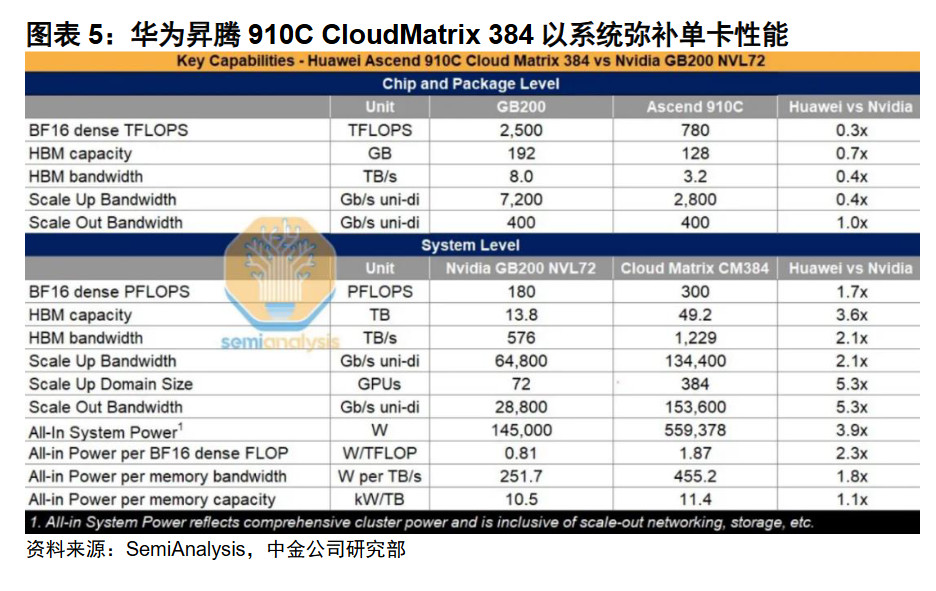
从供给端看,在先进制程受限的背景下,国产芯片如果只按单卡对单卡,很难在短期内完全弥合与海外先进卡的差距。超节点通过系统级优化,将多颗芯片高速互联、统一调度,实现“以系统能力弥补单芯片差距”。华为CloudMatrix384在算力总量、HBM总量和Scale Up带宽等方面已超过英伟达GB200 NVL72。
多家机构对超节点市场规模给出了清晰的测算。
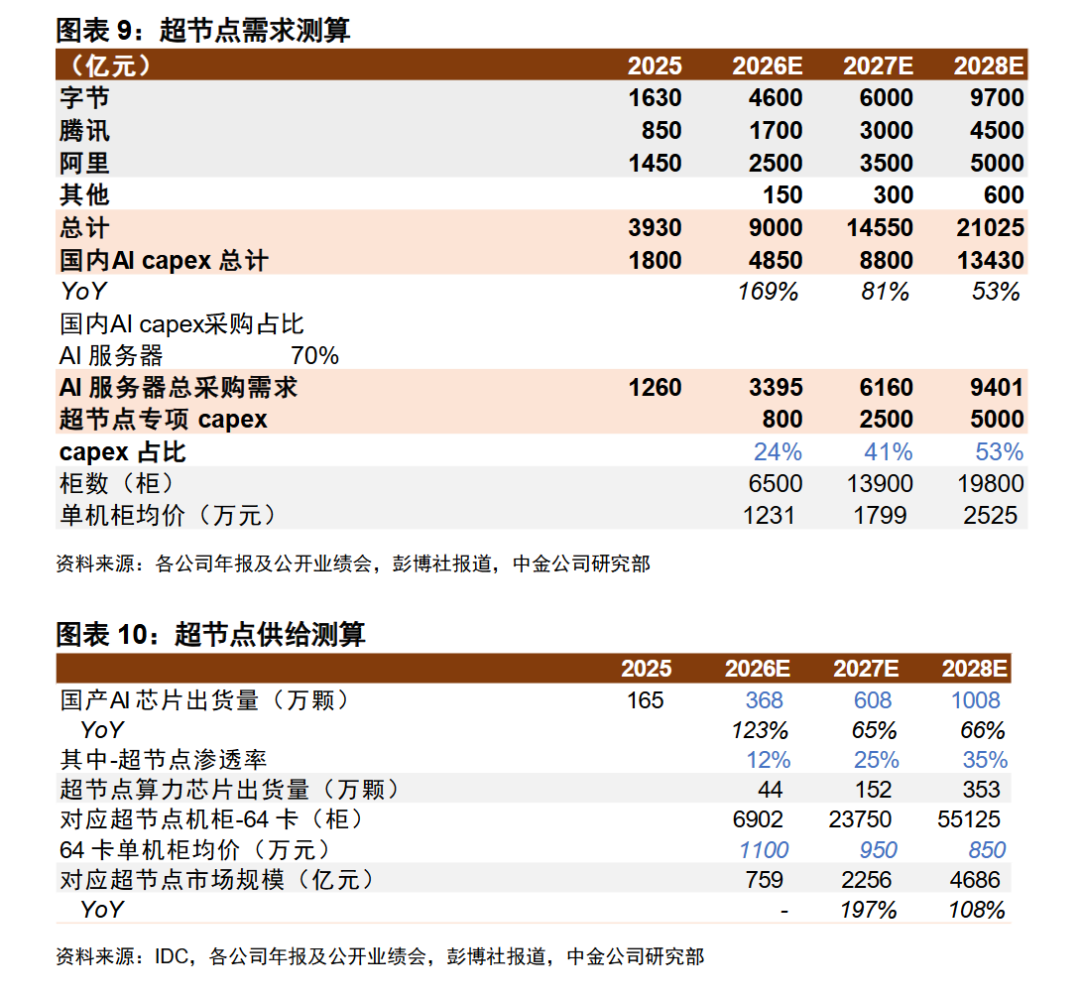
中金综合自上而下(capex视角)及自下而上(供给瓶颈视角)测算,2026/2027年国产超节点机柜的市场规模约为759/2256亿元,对应等效64卡机柜出货量约为0.69/2.38万柜。从架构设计变化的思路看,互联和ODM的价值量跃升明显。
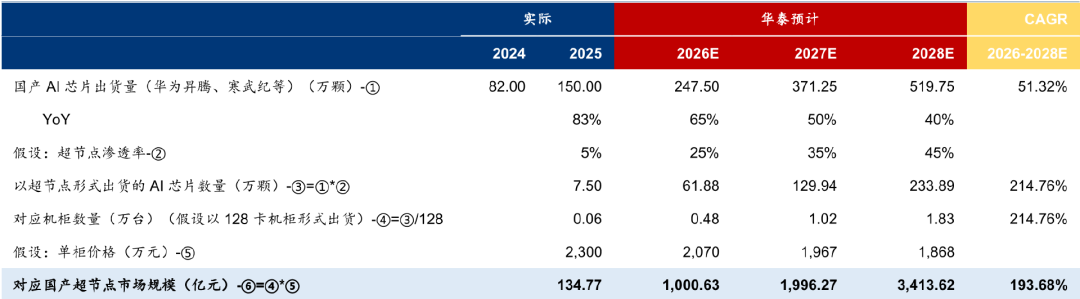
华泰证券测算2028年国产超节点市场空间有望达到3414亿元,2026年至2028年复合年增长率高达194%。超节点起量或将首要带动Scale Up环节公司利润增长,其他算力链也将渐次受益。
受益环节
1、光模块:NPO打开光电互联接口增量
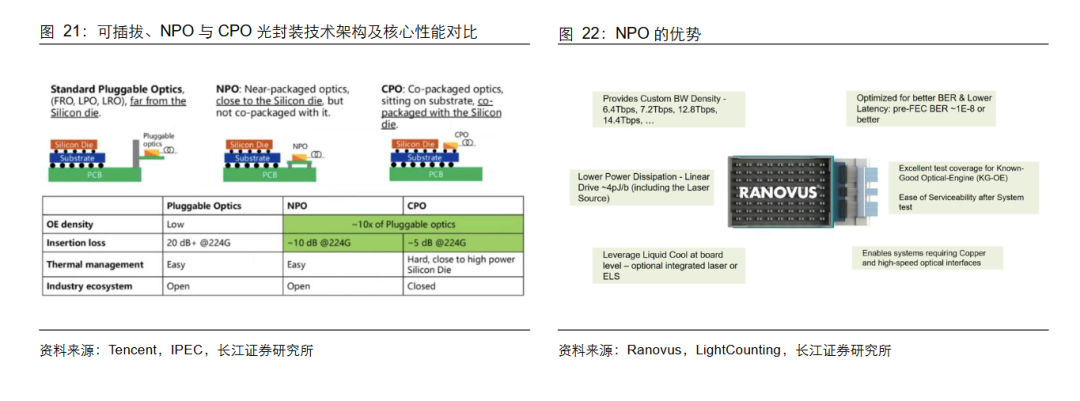
Scale Up光互联向跨柜、集群化方向演进,打开光通信新增量。NPO与CPO通过缩短电链路实现高带宽密度、低插损、低功耗与低TCO。其中,NPO方案可以复用成熟可插拔供应链,良率更高、易维护、生态开放,在供应生态和实现难度层面更具备可行性。NPO光引擎定制属性强化,产业链价值量同步提升。
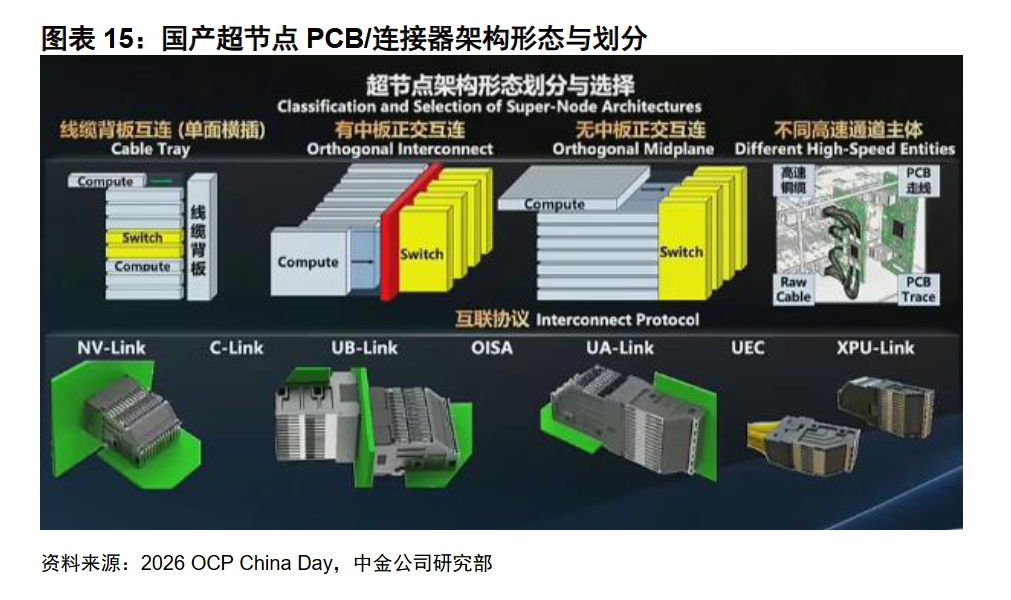
2、PCB&铜连接:Scale Up通信链路增加,三类硬件架构并存
超节点把AI芯片之间的Scale Up通信从“机内少量高速连接”扩展为“整柜级海量高速连接”,英伟达GB200 NVL72使用高达5184根铜缆以及NVLink Switch Tray和Cable Cartridge,这意味着PCB/高速连接器和线缆不再是低价值辅料,而是决定系统带宽、时延和良率的关键部件。
3、交换机/交换芯片:XPU直连创造增量,且配比优化
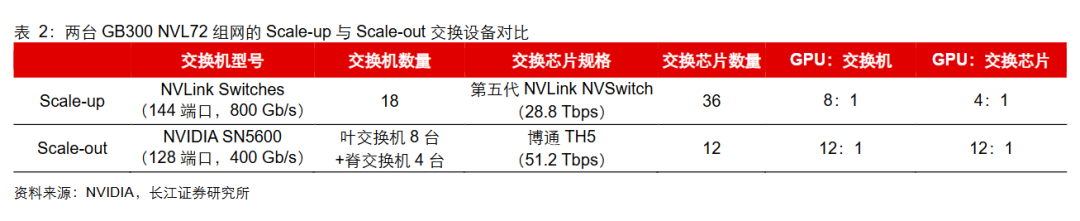
传统架构通常先在单台服务器内部连接8张左右的XPU,服务器之间再通过以太网或InfiniBand进行Scale Out通信;超节点则将高速、低时延的Scale Up互联范围扩大至整机柜甚至跨机柜,同时,跨节点之间的连接仍需Scale Out通信。随着互联范围扩大,一方面,原本由卡间直连或板载器件承担的通信,需要增加独立交换设备和多级交换网络,带动交换机及交换芯片数量增长;另一方面,超节点要求网络具备更高带宽、更低时延、更大端口密度、无阻塞转发和更强可靠性,推动产品由通用数据中心交换设备向高性能Scale Up专用设备升级,进而提高单机和单芯片价值量。
4、液冷:从选配成为标配
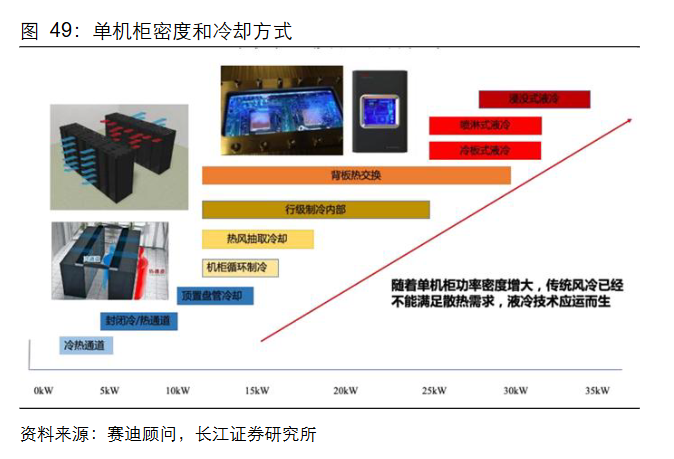
超节点由于单柜集成度提高,功率密度显著提升,液冷成为标配。2025年以前,从芯片端来看,昇腾是液冷芯片的核心推动方,但由于液冷仍为选配,渗透率爬升较慢。2025年以来,昇腾、昆仑芯、阿里等厂商相继发布标配液冷的超节点方案,对标英伟达NVL72机柜级方案,液冷也成为超节点的重要边际变化项,超节点单机柜峰值功耗基本均突破100kw;2026年,超节点方案逐步落地,标志着国内液冷市场开启标配时刻,国内液冷厂商有望受益于超节点产品落地放量。
5、ODM/OEM:从白牌服务器转向高复杂度整柜交付,组装测试附加值提升
相较于传统服务器,超节点机柜的组装测试环节分工细化,涉及L1-L12共12个流程。传统服务器主要考验主板设计、散热设计、组装测试和成本控制能力,而超节点要求厂商同时具备计算节点、网络节点、背板/线缆连接、液冷、供电、整柜测试、信号完整性、系统级burn-in和客户现场交付的能力。工序拉长驱动组装测试附加值提升,同时,系统复杂度提升大幅增加了组装测试的壁垒,组装测试环节的附加值和盈利能力均有望实现提升。
在模型越来越大、推理占比提升、国产先进制程受限的背景下,超节点已成为中国AI基础设施的核心形态。围绕机柜形态的演进,芯片、互联、光模块、铜连接、交换机、液冷、ODM等多个环节均将实现价值量跃迁。一个数千亿级的市场正加速兑现。
发现报告商业局
发现报告旗下传递新经济商业知识的阵地。
我们需要先了解这个世界,才能思考,或创造。