猜你想问
DeepSeek-R1系列推理模型有哪些核心特点?
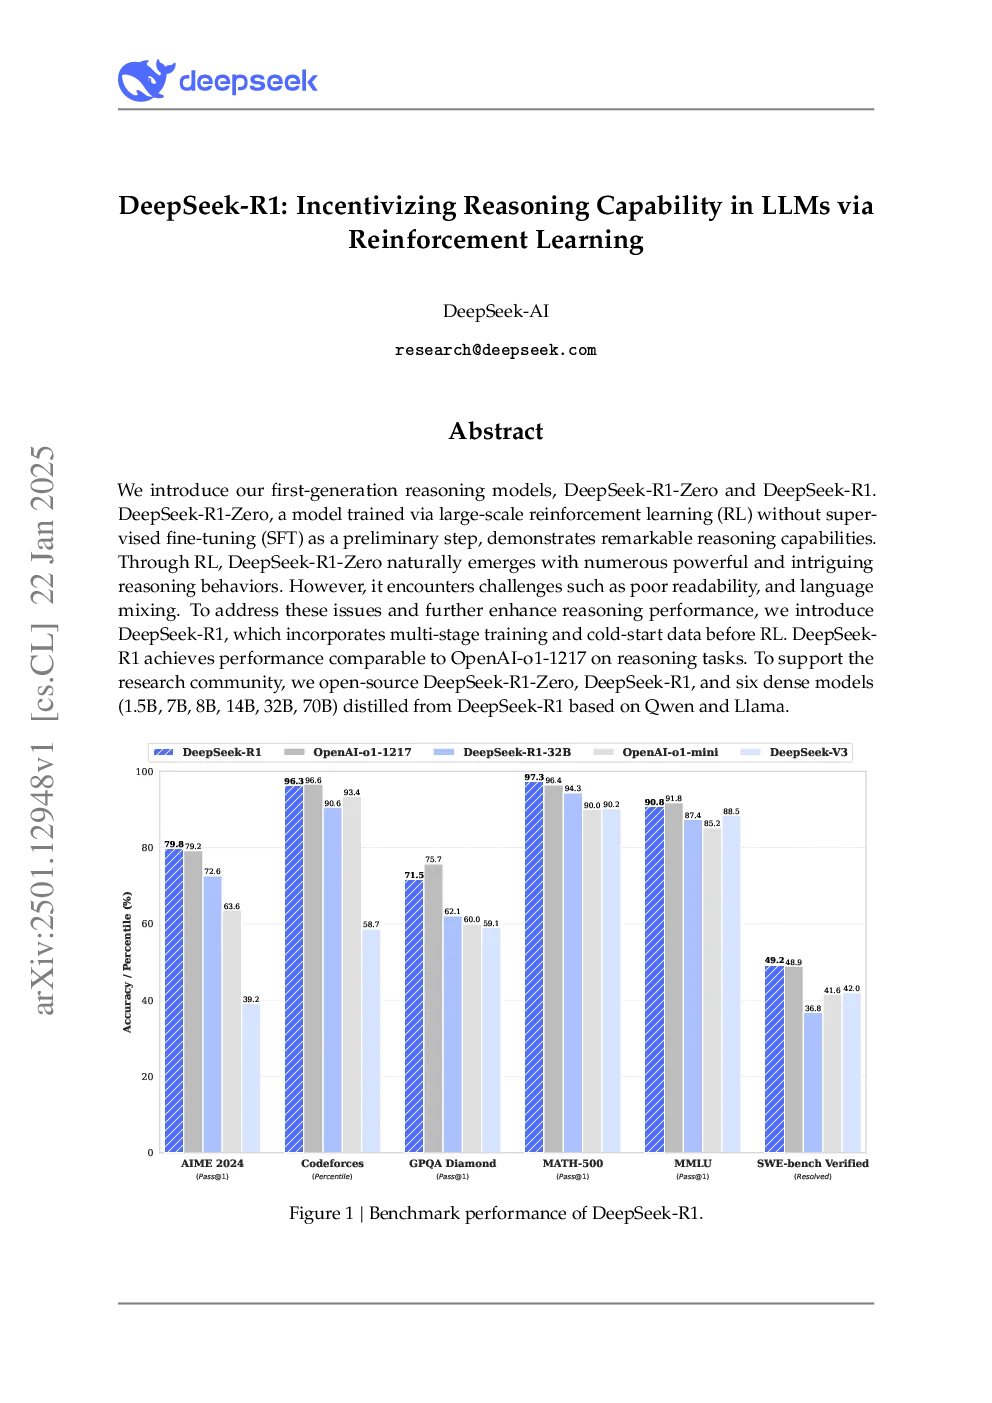
DeepSeek-R1系列推理模型包括DeepSeek-R1-Zero和DeepSeek-R1。DeepSeek-R1-Zero通过大规模强化学习训练,无需监督微调数据便展现出卓越推理能力,在AIME 2024、MATH-500等基准测试中取得优异成绩,如AIME 2024的pass@1得分从15.6%提升至71.0%。DeepSeek-R1则融合少量冷启动数据和多阶段训练流程,包括微调、推理导向强化学习、拒绝采样创建SFT数据及重新训练,性能与OpenAI-o1-1217相当。此外,DeepSeek-R1的推理能力可蒸馏到小型密集模型中,如Qwen和Llama,显著提升性能。
大语言模型推理能力提升的行业发展趋势如何?
大语言模型推理能力提升正成为AI行业重要发展方向。传统依赖监督微调(SFT)的方式正被纯强化学习(RL)训练逐渐替代,如DeepSeek-R1-Zero无需SFT数据即达行业领先水平。同时,推理能力蒸馏技术将大模型优势下沉至小型模型,降低部署门槛。未来,强化学习与大模型结合、推理能力轻量化将是行业主流趋势,推动AI在复杂任务处理、决策支持等领域应用深化。
本报告重点分析了哪些技术方向?
本报告重点分析了DeepSeek-R1系列模型的强化学习训练方法、冷启动数据处理技术以及推理能力蒸馏策略。具体包括:1)DeepSeek-R1-Zero的无监督强化学习训练及其在基准测试中的表现;2)DeepSeek-R1的多阶段训练流程,如冷启动微调、推理导向强化学习、动态SFT数据生成;3)将DeepSeek-R1推理能力蒸馏到Qwen、Llama等小型模型的实践,展现性能显著提升。这些技术为提升大模型推理能力提供了新路径。
当前大模型推理能力市场处于什么阶段?
当前大模型推理能力市场处于技术突破与商业化探索并进阶段。一方面,以DeepSeek-R1为代表的纯强化学习训练模型展现出超越传统SFT方法的潜力,推动推理能力发展范式革新;另一方面,推理能力蒸馏技术正加速大模型在资源受限场景的应用。市场仍面临模型可读性、泛化能力等挑战,但整体呈现技术快速迭代、应用场景不断拓展的态势,未来有望在智能客服、金融风控等领域发挥更大价值。
本报告提示哪些潜在风险?
本报告提示以下潜在风险:1)强化学习训练的模型可读性较差,推理过程缺乏透明度,可能影响用户信任;2)纯强化学习训练可能存在过拟合或泛化不足问题,需持续优化算法;3)推理能力蒸馏过程中可能丢失大模型的某些特性,影响模型整体表现;4)当前技术仍处于发展阶段,大规模商业化应用尚需时日。投资者需关注技术成熟度及行业应用落地进程。