DeepSeek 核心概述
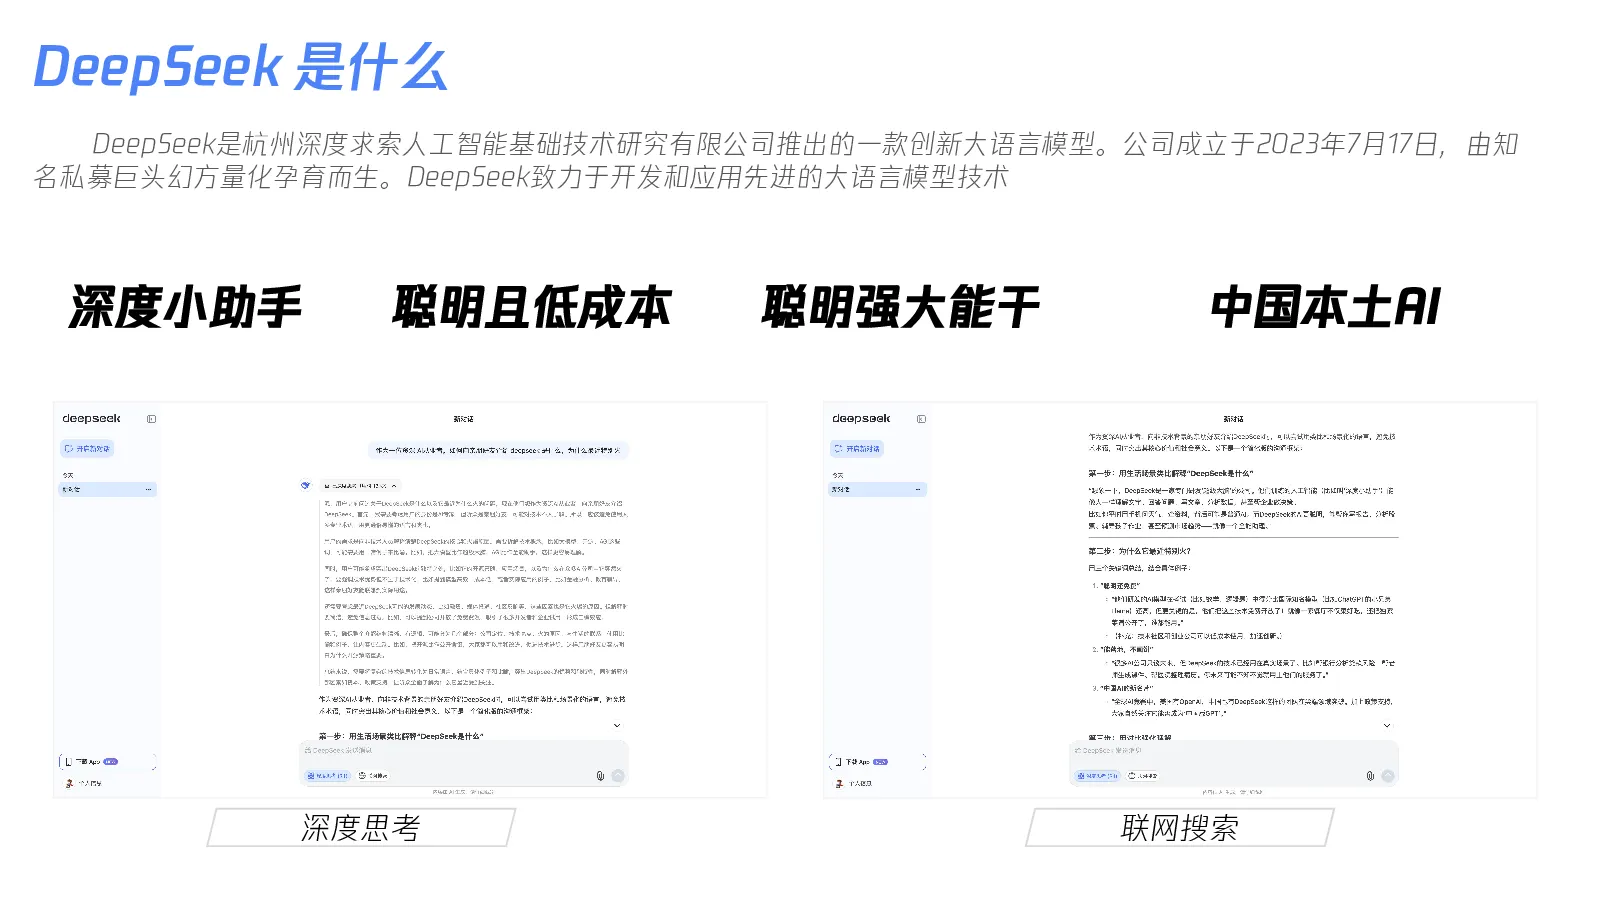
DeepSeek 是由杭州深度求索人工智能基础技术研究有限公司推出的一款创新大语言模型,公司成立于 2023 年 7 月 17 日,由幻方量化孕育而生。DeepSeek 致力于开发和应用先进的大语言模型技术,具有深度思考、联网搜索、低成本、聪明且强大的特点。
大语言模型的特点
- 内容 token 化:大模型通过将文本切割为 Token 的基本单元进行处理,DeepSeek R1 推理模型能够正确回答关于英文单词中字母数量的问题。
- 知识库截止日期:DeepSeek R1 的知识库截止于 2023 年 12 月,因此只能提供在此日期之前发布的信息和常识。
- 自我认知:目前 AI 大模型(包括 DeepSeek)没有自我认识或自我意识,无法回答关于自身是谁或采用什么模型的问题。
- 上下文长度限定:AI 大模型记忆力有限,DeepSeek R1 提供 64k token 的上下文长度,对应中文约 3 万至 4 万字。
- 回答输出长度有限:AI 大模型无法一次性完成万字长文,DeepSeek 提供解决方案,如先生成目录再输出模块,或多次输入/调用 API。
DeepSeek 发展由来
DeepSeek 来自杭州深度求索公司,专注于开发先进的大语言模型(LLM)和相关技术。公司由幻方量化全资孕育而生,使用数据蒸馏技术得到更为精炼、有用的数据。
DeepSeek 的优势
- 技术突破:DeepSeek 在模型架构、数据质量与领域适配、开放模型与工具链方面具有技术优势。
- 开源生态:DeepSeek 全量开源,降低复现和二次开发门槛,极大推动开发者社区创新。
- 行业落地:DeepSeek 推动技术范式迁移,从通用模型到领域专家,降低企业部署成本。
- 行业竞争格局:DeepSeek 的开源策略倒逼闭源模型降价,催化国产 AI 芯片生态,推动 AGI 技术民主化。
DeepSeek 的核心技术
- MLA 多头注意力架构:通过低秩键值联合压缩功能,减少 KV 缓存占用空间,提高推理效率。
- DeepSeekMoE 架构:采用细粒度的专家分割和共享专家隔离策略,实现更高的专家专业化潜力。
- Multi-Token 预测(MTP):一次预测多个 Token,提升训练和推理性能。
- DualPipe 调度策略 + 细粒度的混合精度框架:优化基础设施,提高通信效率,加速模型训练。
- R1-zero 基础模型上的强化学习:验证纯强化学习对推理能力的提升。
- R1 具有冷启动的强化学习:通过冷启动和多阶段训练,增强可读性和性能。
DeepSeek 的应用场景
DeepSeek 在零售、教育、金融、医疗等领域具有广泛应用,如数据驱动的精准运营、自适应学习生态、智能风控系统、影像辅助诊断等。
DeepSeek 的技术发展趋势
DeepSeek 正在推动通用智能与垂直场景的双重进化,包括大模型持续扩展参数规模、泛化、多模态统一建模、自主决策能力增强、世界模型构建、因果推理升级、人机协作深化、具身智能、伦理安全框架等。
与同行技术的比较
DeepSeek 在性能、应用场景和创新能力方面具有优势,如中文任务、代码生成、实时决策能力突出,资源效率高,开源战略吸引开发者,但多模态支持较弱,长上下文处理能力有限。
如何高效用好 DeepSeek
- 了解大语言指令模型和推理模型的工作原理与局限。
- 清晰明确表达需求,交代清楚背景、目标和限制条件。
- 避免模糊的指令、过于宽泛的问题、过于复杂或冗长的描述、歧义或模糊的词汇、矛盾或不切实际的要求、重复提问。
总结
DeepSeek 是一款具有深度思考、联网搜索、低成本、聪明且强大的创新大语言模型,具有多项核心技术优势,在多个领域具有广泛应用,并正在推动通用智能与垂直场景的双重进化。通过了解其工作原理和局限,并清晰明确地表达需求,可以高效地使用 DeepSeek 解决各种问题。