摘要
过去做一次行业研究,意味着在多个站点间反复切换:先搜关键词,再翻目录,再找图表,再截图归档。 一份深度材料的整理过程,大部分时间消耗在「找」而不是「想」上。
发现报告把 610 万+ 研报与 4,800 万+ 图表数据资产, 封装成三种标准化接入方式 —— Skills 对话、CLI 脚本、MCP 直连,让 AI 从「帮你搜」进化为「替你把研究做完」。
无论选择哪一种,底层调用的都是同一套能力:报告搜索、段落精读、PDF 下载。 区别只在于谁来调用 —— 研究员用 Skills 对话,开发者用 CLI 编排,AI Agent 用 MCP 直连。
我们对外提供三种接入方式:
- 1 Skills 深度研究,面向研究员。自然语言触发,AI 先按 MECE 原则拆解研究子问题,再定向检索、筛选核心研报、精读并沉淀事实卡片,最终输出可追溯的结构化调研报告。研究边界、资料来源、事实卡片与推导过程全部落盘,每一步都可回查。适配 Codex / Claude / WorkBuddy。
- 2 CLI 命令行工具,面向开发者。终端一条命令完成搜索、阅读、下载。支持批量处理与脚本编排,可轻松集成 CI/CD 自动化流水线,也能挂上定时任务定期抓取行业周报月报。
- 3 MCP 协议接口,面向 AI Agent。让 WorkBuddy、Claude Desktop、Cursor 等 Agent 直接调用发现报告能力,在线版零安装即用,本地版一键启动,实现无人值守的研报研究闭环。
接入门槛只有一步:开通高级 VIP 获取 API Key,配置环境变量,即可在三种方式中立即使用。
三个数字支撑这套体系:610 万+ 累计收录研报、4,800 万+ 图表数据资产、25 大行业全覆盖。 我们相信,未来的研究工作不是 AI 替代研究员,而是研究员 + AI + 专业研报数据的协同进化。 发现报告要做的,是这场进化里可被随时调用的那层基础设施。
立即接入,让你的研究流程跑在 AI 的工作流里。
风险提示 本文所述工具、数据及报告均为账号授权范围内的公开研报资源,平台仅提供数据检索与接口调用能力,不包含任何 AI 生成内容,全部内容仅供参考与研究使用,不构成投资建议、买卖推荐或操作指令。
一AI 做研报研究的四类困境
在接入之前,用 AI 辅助研究,普遍面临以下四个问题。
1搜得到,但筛不出来
AI 联网搜索能返回一批链接,但研报是长文档 —— 真正有价值的判断往往埋在第 37 页的第二章。搜索引擎给的是链接而不是观点,是相关度而不是研究结论。研究员拿到十条结果,仍然要逐份点开、逐页翻找,筛选成本不降反升。
2读得快,但追不回去
AI 总结出来的结论读起来头头是道,但关键数据出自哪份报告的哪一页,往往说不清楚。研究是要落笔的 —— 写进报告里的每一个数字都必须能回查原文。不可追溯的结论,等于不可用的结论。
3说得头头是道,但没有研究框架
直接问 AI「光模块行业怎么样」,得到的是一段泛泛的概述。但真正的研究是从问题拆解开始的:这个行业该看哪几个子问题?市场规模、竞争格局、技术路线、产能周期,先问什么、后问什么、彼此怎么验证?没有框架的问答,得到的只是信息碎片。
4每一轮研究都从零开始
这一轮研究做完,材料散落在浏览器收藏夹、下载文件夹和聊天记录里。下一轮换个主题,前面沉淀的事实卡片、对比框架、资料来源全部作废,只能重新再来一遍。研究资产没有沉淀,就不会产生复利。
发现报告把 610 万+ 研报与 4,800 万+ 图表封装成三个标准化接口,再通过 Skills、CLI、MCP 三种方式接入 AI 工作流 —— 问题由 AI 拆解,检索与精读由平台执行,事实与来源由工作区沉淀。 从「搜得到」到「拿得准」,从「用一次」到「攒起来」,这正是这套接入体系要解决的事。
二发现报告 AI 接入总览
(一)三种接入方式,一个能力底座
无论选择哪种方式,底层调用的都是同一套能力:
- ·报告搜索:按关键词、机构、时间范围检索,返回标题、机构、发布时间、行业、页数及命中的正文片段
- ·段落精读:给定报告 ID,返回摘要、目录与命中段落
- ·PDF 下载:给定报告 ID,获取下载地址或直接下载到本地
三种方式的差别只在「谁在调用、怎么调用」:
| Skills 深度研究 | CLI 命令行工具 | MCP 协议接口 | |
|---|---|---|---|
| 调用者 | 研究员(对话式) | 开发者(脚本化) | AI Agent(直连) |
| 一句话 | 自然语言触发的研究工作流 | 终端一条命令搜索、阅读、下载 | 让 Agent 直接调用平台能力 |
| 交付物 | 完整研究工作区 | 单次操作结果 | 工具调用能力 |
| 最佳场景 | 单次深度研究 | 批量 / 定时 / CI-CD | 无人值守研究闭环 |
| 安装形态 | zip 自动安装 或 git clone 到 skills 目录 | 单文件二进制包,解压即用 | 在线版零安装;本地版 uvx 一键启动 |
| 兼容客户端 | Codex / Claude / WorkBuddy | 任意终端(macOS / Linux / Windows) | WorkBuddy、Claude Desktop、Cursor 等 |
(二)接入前置:高级 VIP 与 API Key
三种方式共用同一个凭证。开通高级 VIP 后获取 API Key:
- ·开通高级 VIP:www.fxbaogao.com/user
- ·获取 API Key:www.fxbaogao.com/user/userInfo
配置完成后,三种接入方式即可立即使用。
(三)能力全景:接口、命令与工具的对应关系
平台的三个底层能力,在三种接入方式中是一一对应的。这张表也是理解整套体系的关键:
| 底层能力 | 底层接口 | CLI 命令 | MCP 工具 |
|---|---|---|---|
| 报告搜索 | POST /mofoun/agent/search | fxbaogao search | search_reports |
| 段落精读 | POST /mofoun/agent/paragraph | fxbaogao paragraph | get_paragraphs |
| 取 PDF 地址 | GET /mofoun/agent/download | fxbaogao pdf-url | get_pdf_url |
| 下载 PDF 到本地 | 同上 | fxbaogao download | —(MCP 仅取地址,本地下载走 CLI) |
MCP 端点实际暴露 3 个工具(search_reports / get_paragraphs / get_pdf_url),未包含本地下载;需要落盘 PDF 时用 CLI 的 fxbaogao download。
统一规范 Base URL 为 https://api.fxbaogao.com;鉴权头为 Authorization: Bearer <API Key>;请求类型 application/json。
时间参数支持快捷写法:last3day / last7day / last1mon / last3mon / last1year,也可传毫秒时间戳字符串。
三三种接入方式详解
(一)Skills 深度研究
它是什么 / 原理
一个面向发现报告的 AI 客户端 Skill(适配 Codex / Claude / WorkBuddy 等)。核心方法是「先想后搜」: 先定义研究边界,用 MECE 原则拆解 3–7 个子问题,再基于子问题定向检索研报、筛选核心材料、精读并沉淀事实,最后形成结构化结论。
它不是「只返回搜索结果」—— 而是把问题拆解、资料来源、事实卡片、对比框架、推导过程全部落盘,形成可复核、可交付的研究工作区。
前置条件
- ·支持 Skill 的 AI 客户端(Codex / Claude / WorkBuddy 等)
- ·有效的发现报告 API Key
如何接入
方式一(推荐 · 交给 AI 安装):把下面这段提示词直接发给 AI 客户端。
方式二(手动安装):
如何使用
自然语言触发即可,无需记任何命令:
多篇深度研究会先输出研究边界、核心问题和 3–7 个 MECE 子问题搜索矩阵,再进入检索;单篇报告精读则直接进入精读流程,不创建完整多篇研究工作区。
输出物:研究工作区
四条硬性约束(这也是它可被信任的原因)
- 1调用搜索接口前,先产出研究边界和 MECE 子问题搜索矩阵 —— 不允许跳过拆解直接搜;
- 2所有资料必须保留报告 ID 和官网阅读链接
https://www.fxbaogao.com/view?id=<reportId>,保证每条结论可回查; - 3paragraph 回包只适合快速初筛;正式研究、原文引用、关键数据核验必须下载 PDF 并基于原文核对;
- 4不伪造作者、机构、日期、摘要、页码或数据口径。
(二)CLI 命令行工具
它是什么 / 原理
fxbaogao 是发现报告的命令行工具,把搜索、段落、下载三项能力封装成终端命令。
它是单文件二进制,解压即用,不依赖运行时环境。
它的主场是批量与自动化:可以写进 shell 脚本、接进 CI/CD 流水线,也可以挂上 Cron 定时任务,
定期把行业周报、月报抓下来推送到邮箱或飞书。
如何安装
从发布包中选择与系统匹配的文件:
| 系统 | 文件 |
|---|---|
| macOS Apple Silicon | fxbaogao-darwin-arm64.tar.gz |
| macOS Intel | fxbaogao-darwin-amd64.tar.gz |
| Linux x86_64 | fxbaogao-linux-amd64.tar.gz |
| Linux ARM64 | fxbaogao-linux-arm64.tar.gz |
| Windows x86_64 | fxbaogao-windows-amd64.zip |
发布包可使用 checksums.txt 校验完整性:
命令总览
如何使用
搜索报告:
默认输出为「报告ID 标题 机构 日期 官网阅读链接」;需要结构化处理时加 --json 输出原始 JSON。
获取报告段落:
返回报告摘要与命中正文段落。注意:该回包适合快速初筛,正式引用或精读时应下载 PDF 并基于原文核对。
获取 PDF 下载地址与下载 PDF:
不指定 --out 时默认保存到 downloads/<报告ID>.pdf;已存在同名文件时加 --overwrite 覆盖。
(三)MCP 协议接口
它是什么 / 原理
Model Context Protocol(MCP)是一套开放协议,用于让 AI Agent 以标准化的方式连接外部工具和数据源。 可以把它理解为「AI 世界的 USB 接口」:不管数据在数据库、API 还是文件里,只要按 MCP 规范封装成工具, 任何兼容 MCP 的客户端都能即插即用地调用。
发现报告把搜索、段落、PDF 地址三项能力封装成 MCP 工具。 Agent 在对话中自动发现可用工具及其参数,按需调用,无需人工把结果复制粘贴回去 —— 这是它和普通联网搜索最本质的区别。
两种部署形态
- ·在线 HTTP 版:零安装,直接用远程地址,适合大多数用户
- ·本地版:通过
uvx一键启动,以stdio方式在本机运行,适合有本地化或内网要求的场景
如何配置
授权方式(MCP 为预填 Key):到发现报告用户中心自取 API Key,按下面示例预先填入 —— MCP 服务通过配置中的 Bearer Key 完成鉴权,需要预先填好 Key 才能连通,不支持登录后自动授权。如需「登录授权弹框、登录即授权」的免配置体验,可使用 WorkBuddy 技能(Skills)方式接入(见「六、应用实例」案例一方式 B)。
在线 HTTP 版,用命令行添加:
或使用 JSON 配置远程 MCP:
本地版,通过 uvx 启动:
本地开发时也可以从源码运行:
三个可用工具
| 工具名 | 作用 | 主要参数 |
|---|---|---|
search_reports |
按关键词、机构、时间范围搜索研报 | keywords、orgNames、startTime、endTime、pageNum(默认 1,取值 1–10) |
get_paragraphs |
获取指定报告的摘要、目录与正文命中段落 | reportId(必传)、keyword |
get_pdf_url |
获取指定报告的 PDF 地址 | reportId(必传) |
MCP 端点未提供本地下载工具:PDF 地址由 get_pdf_url 获取;需要把 PDF 下载到本地时,用 CLI 的 fxbaogao download。
search_reports 的返回结果会自动补充官网阅读链接 https://www.fxbaogao.com/view?id=<reportId>,便于回查与引用。
如何使用
在 Agent 对话里直接提出研究需求即可,例如:
Agent 会自动完成工具选型、参数填充、调用与结果解读。三个工具形成一条完整链路:搜索 → 精读 → 取地址;需要把 PDF 下载到本地时,配合 CLI 的 fxbaogao download 即可。
四六大使用场景
无论你是做投研、写报告、搭 Agent,还是跑自动化,都能找到对应场景。
行业竞争格局研究
Skills想了解光模块、储能、AI 算力赛道?AI 自动拆解子问题,跨报告检索核心观点,沉淀事实卡片与推导过程。
公司尽调与投研
Skills针对目标公司,跨机构研报交叉验证关键数据和风险点,输出可追溯的结构化调研报告。
单篇报告精读
Skills给出报告 ID,自动提取摘要、目录和命中段落;区分 paragraph 概览与 PDF 原文精读,提炼关键事实与风险。
AI Agent 自主研究
MCP让 Claude、Cursor 等 Agent 自主调用搜索、阅读和下载能力,实现无人值守的研报研究闭环。
定期研报自动化
CLI + Cron定时抓取行业周报、月报,自动推送到邮箱或飞书,告别手动收集整理。
批量报告筛选
CLI按关键词、机构、时间范围批量搜索,快速筛选核心报告并下载 PDF,适合深度研究前的广撒网。
| 场景 | 适合谁 | 用哪种方式 | 具体做法 |
|---|---|---|---|
| 行业竞争格局研究 | 行业研究员 | Skills | 自动拆解子问题,跨报告检索核心观点,沉淀事实卡片与推导过程 |
| 公司尽调与投研 | 投研人员 | Skills | 跨机构研报交叉验证关键数据和风险点 |
| 单篇报告精读 | 研究员 | Skills | 给报告 ID,提取摘要、目录与命中段落,区分概览与原文精读 |
| AI Agent 自主研究 | Agent 开发者 | MCP | Agent 自主调用搜索、阅读、下载,无人值守闭环 |
| 定期研报自动化 | 开发者 | CLI + Cron | 定时抓取周报月报,推送邮箱或飞书 |
| 批量报告筛选 | 研究员 / 开发者 | CLI | 按关键词、机构、时间批量搜索并下载 PDF |
开通高级及以上 VIP,即可使用全部场景能力。
五三种接入方式怎么选
我们注意到,经常有这样一个讨论:有了 CLI,为什么还要 MCP?有了 MCP,为什么还要 Skill?
我们的判断是:三者不是替代关系,而是面向不同调用者、处在不同交互粒度上的三种解法。
① 调用者不同:人、脚本、Agent
Skills 面向研究员 —— 人在对话里提出研究需求,AI 负责执行;CLI 面向开发者 —— 把能力写进脚本、流水线和定时任务;MCP 面向 AI Agent —— 由 Agent 自主决策何时调用哪个工具。选型的第一步,是问「谁来发起这次调用」。
② 交互粒度不同:一次研究、一次操作、一次决策
Skills 交付的是完整研究工作区,从问题拆解到最终报告;CLI 交付的是单次操作结果,一次搜索、一份 PDF;MCP 交付的是工具能力,具体调用什么由 Agent 在对话中决定。粒度不同,适用任务也就不同。
③ 沉淀方式不同:工作区、脚本、上下文
Skills 把过程落盘成可复核的 Markdown 工作区;CLI 把流程固化成可重复执行的脚本;MCP 把结果留在 Agent 的对话上下文里。需要长期复用的研究,选前者;需要无人值守的闭环,选后者。
实际上,三种方式可以协同工作。一个很典型的模式是:CLI 负责批量取料,Skills 负责深度加工,MCP 负责让 Agent 自主调度 —— 先用 CLI 按行业和时间范围批量筛出候选报告并下载 PDF,再用 Skills 对核心材料做 MECE 拆解与事实沉淀,最后通过 MCP 把整条链路交给 Agent 定时执行。三者各司其职、互相增强。
六国内主流模型应用实例
发现报告的三种接入方式都建立在开放协议之上:MCP 是开放的工具协议,HTTP 接口兼容 OpenAI 的 function calling 规范。近两年国内主流大模型与 Agent 客户端已普遍收敛到「OpenAI 兼容工具调用 + MCP」这套组合,因此同样的能力可以直接落到国内主流模型生态里使用。
先分清两个概念:模型负责思考(DeepSeek、通义千问、GLM、Kimi),客户端是你对话用的软件(WorkBuddy、Qoder、Cherry Studio、Trae 等)。MCP 是客户端的能力 —— 多数模型的官方 App 不开放自定义 MCP 入口,标准做法是在支持 MCP 的客户端里填入模型厂商的 API Key,再添加发现报告 MCP 服务:模型还是那家的模型,研报工具由客户端统一接入。
模型生态:工具调用与 Key 的获取
下表的模型均已支持 OpenAI 兼容的工具调用,任选一家获取 API Key,配合下方任意 MCP 客户端即可使用(各平台支持情况随版本更新,请以官方文档为准):
| 模型 | 厂商 | 工具调用 | API Key 获取 |
|---|---|---|---|
| DeepSeek | 深度求索 | OpenAI 兼容 function calling | platform.deepseek.com |
| 通义千问 Qwen | 阿里云 | OpenAI 兼容 tools;Qwen-Agent 框架内置 MCP 客户端 | 阿里云百炼 bailian.aliyun.com |
| GLM | 智谱 AI | OpenAI 兼容 tools | open.bigmodel.cn |
| Kimi | 月之暗面 | OpenAI 兼容 tools(Kimi 开放平台) | platform.moonshot.cn |
| 豆包 · 扣子 Coze | 字节 | Coze 插件兼容 OpenAPI;火山方舟兼容 OpenAI tools | www.coze.cn |
| 文心 · 千帆 | 百度 | 千帆平台兼容 OpenAI tools | 百度智能云千帆 |
国内主流 Agent 客户端 / IDE
这一类工具原生支持自定义 MCP 服务,在设置里粘贴下方的 JSON 配置即可直接接入,无需写任何代码:
| 客户端 / IDE | 所属 | MCP 配置入口 |
|---|---|---|
| WorkBuddy | 腾讯 | 专家 · 技能 · 连接器 → 自定义连接器 → 配置 MCP,粘贴 JSON 保存(支持 HTTP) |
| CodeBuddy | 腾讯 | 连接器 / MCP 设置中添加自定义 MCP 服务 |
| Qoder | 阿里 | Settings → MCP → 我的服务 → 添加,支持 STDIO / SSE / Streamable HTTP |
| Trae | 字节 | 设置 → MCP → 添加 → 手动添加;另有内置 MCP 市场 |
| Cherry Studio | 开源社区 | 设置 → MCP 服务器 → 添加服务器,支持 Streamable HTTP / SSE / STDIO |
| 通义灵码 | 阿里 | 已在开发者设置中开放 MCP 服务配置 |
通用接入三步
不管用哪家的模型、哪个客户端,接入路径都是同样三步:
-
1
获取 API Key:登录发现报告,在用户中心(个人中心)获取
API Key(形如sk-xxx)。MCP 方式需要预先填好 Key 才能连通 —— 客户端通过配置中的 Bearer Key 完成鉴权,不支持登录后自动授权; -
2
在客户端的 MCP / 工具设置里添加
fxbaogao服务 —— 在线版填入服务地址与 Bearer Key,或直接粘贴下面这段 JSON 配置; - 3 用自然语言下达检索、精读、下载指令,由模型自主调用工具。
注意:MCP 方式仅支持预填 API Key,不支持登录授权 —— Key 需提前取好并写入配置,服务才能连通。想要「登录即完成授权」的免配置体验,请使用技能(Skills)方式接入,两种授权方式均支持。
发现报告 MCP 为远程服务,本地不运行任何程序 —— 无需安装 Node.js / Python / uv 等环境,填入服务地址与 Key 即可。
案例一 · WorkBuddy:对话直达研报检索
WorkBuddy 是内置 Agent 能力的桌面工作台,模型能力开箱即用。在 WorkBuddy 中使用发现报告有两条路径,任选其一即可:方式 A · MCP 服务——把发现报告接入为自定义连接器,Agent 在对话中按需调用检索、精读、取书工具,通用性最强,授权需预先填好 API Key;方式 B · 技能(Skills)——把官方 Skill 安装指令发给 AI 即可自动装好,检索研报变成即装即用的对话能力,配置最省事,支持官方网页授权(登录即完成)与自取 Key 两种授权方式。
接入自定义连接器
MCP 是标准协议,配置完成后所有项目长期复用,Agent 会按任务需要自动调用工具。
-
1
获取 API Key:登录发现报告,到用户中心(个人中心)获取
API Key(形如sk-xxx),后面要用。MCP 方式通过配置中的 Bearer Key 鉴权,需要预先填好 Key 才能连通,不支持登录授权弹框;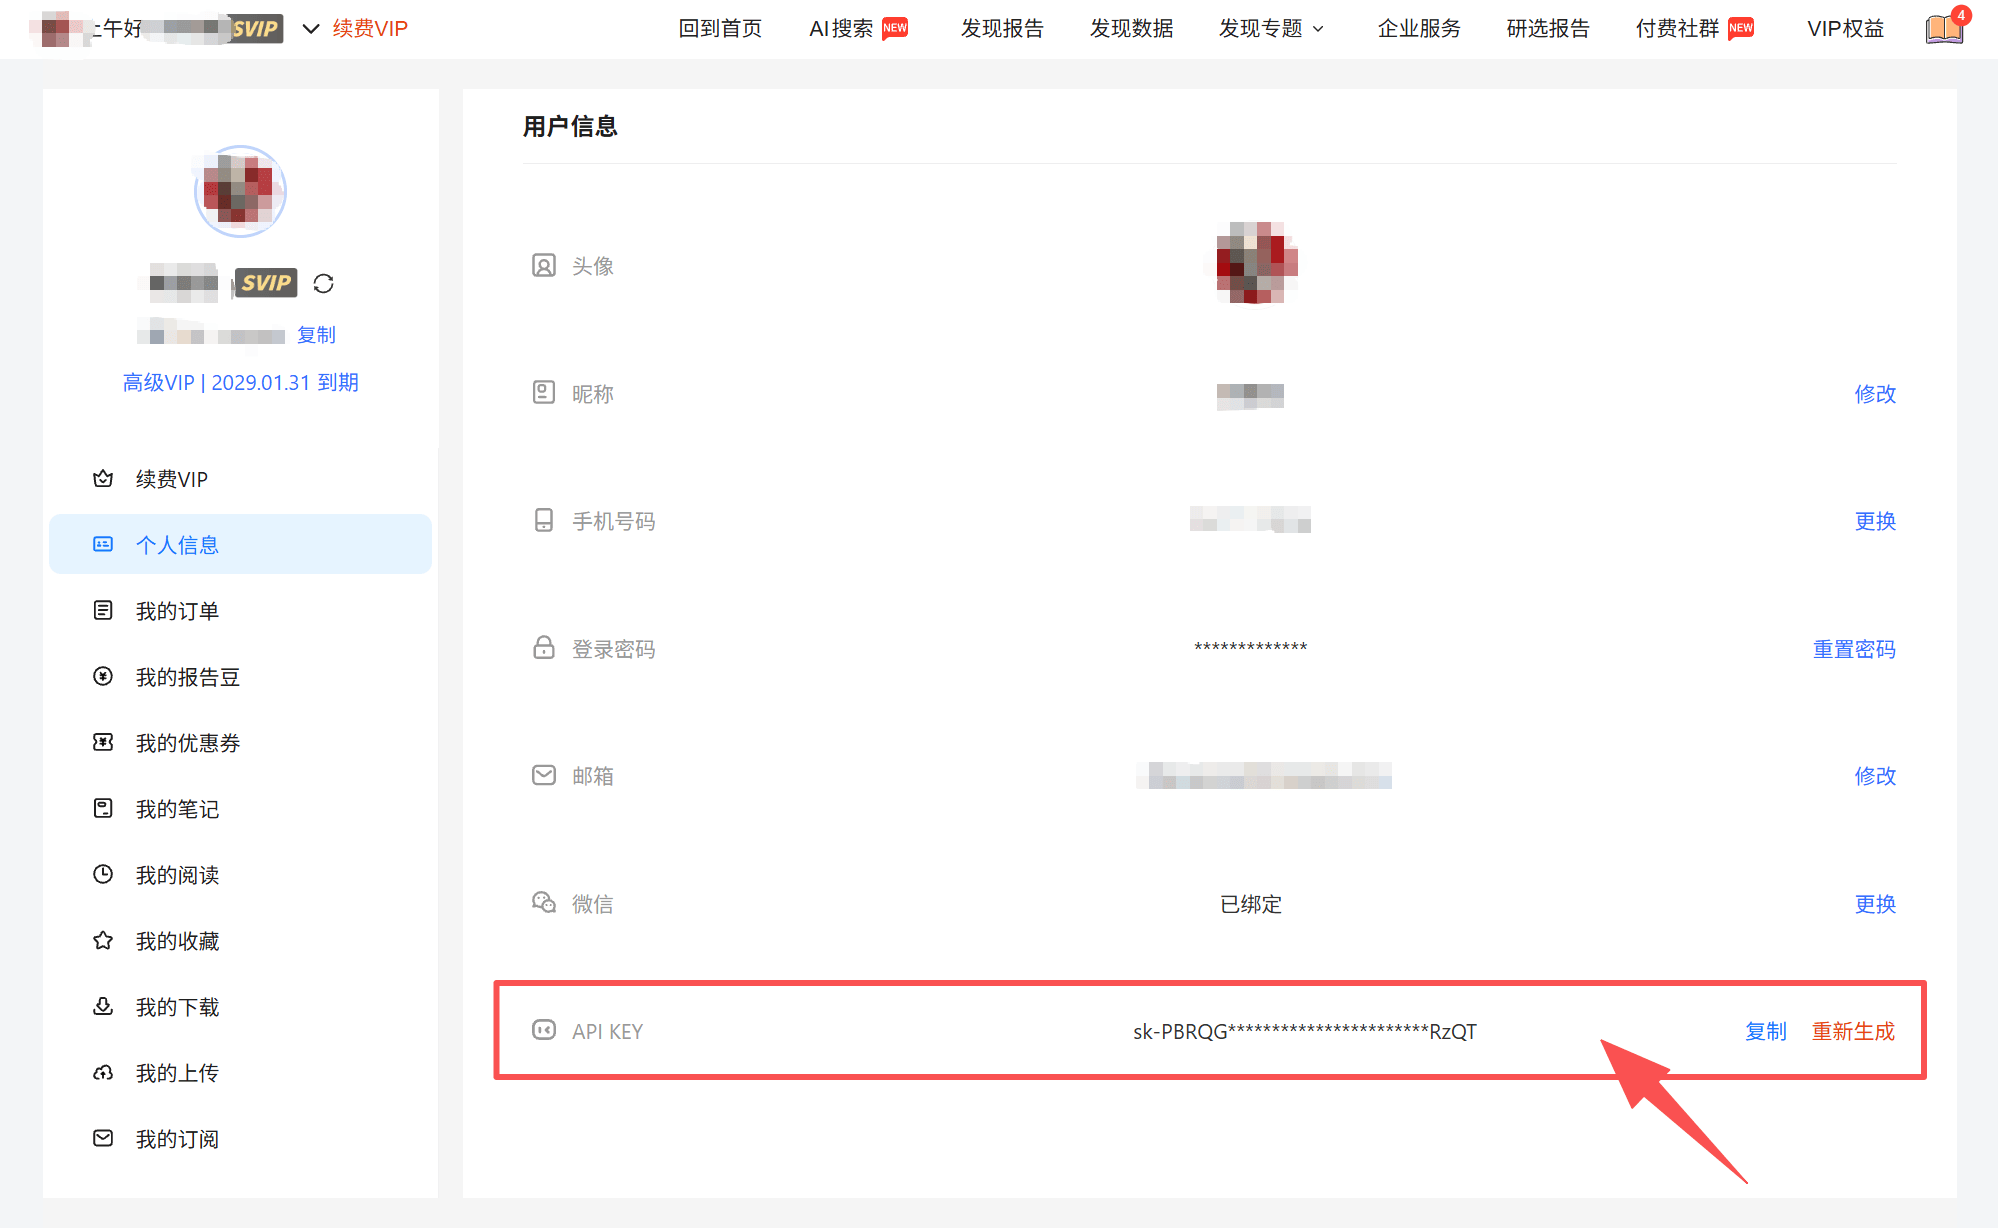
图表 9登录发现报告 → 用户中心「个人信息」,页面底部「API KEY」一栏:点击「复制」取 Key,泄露后可「重新生成」作废旧 Key -
2
找入口:打开 WorkBuddy,在左侧边栏进入「专家 · 技能 · 连接器」,选择「连接器」页签,点击右上角「自定义连接」;
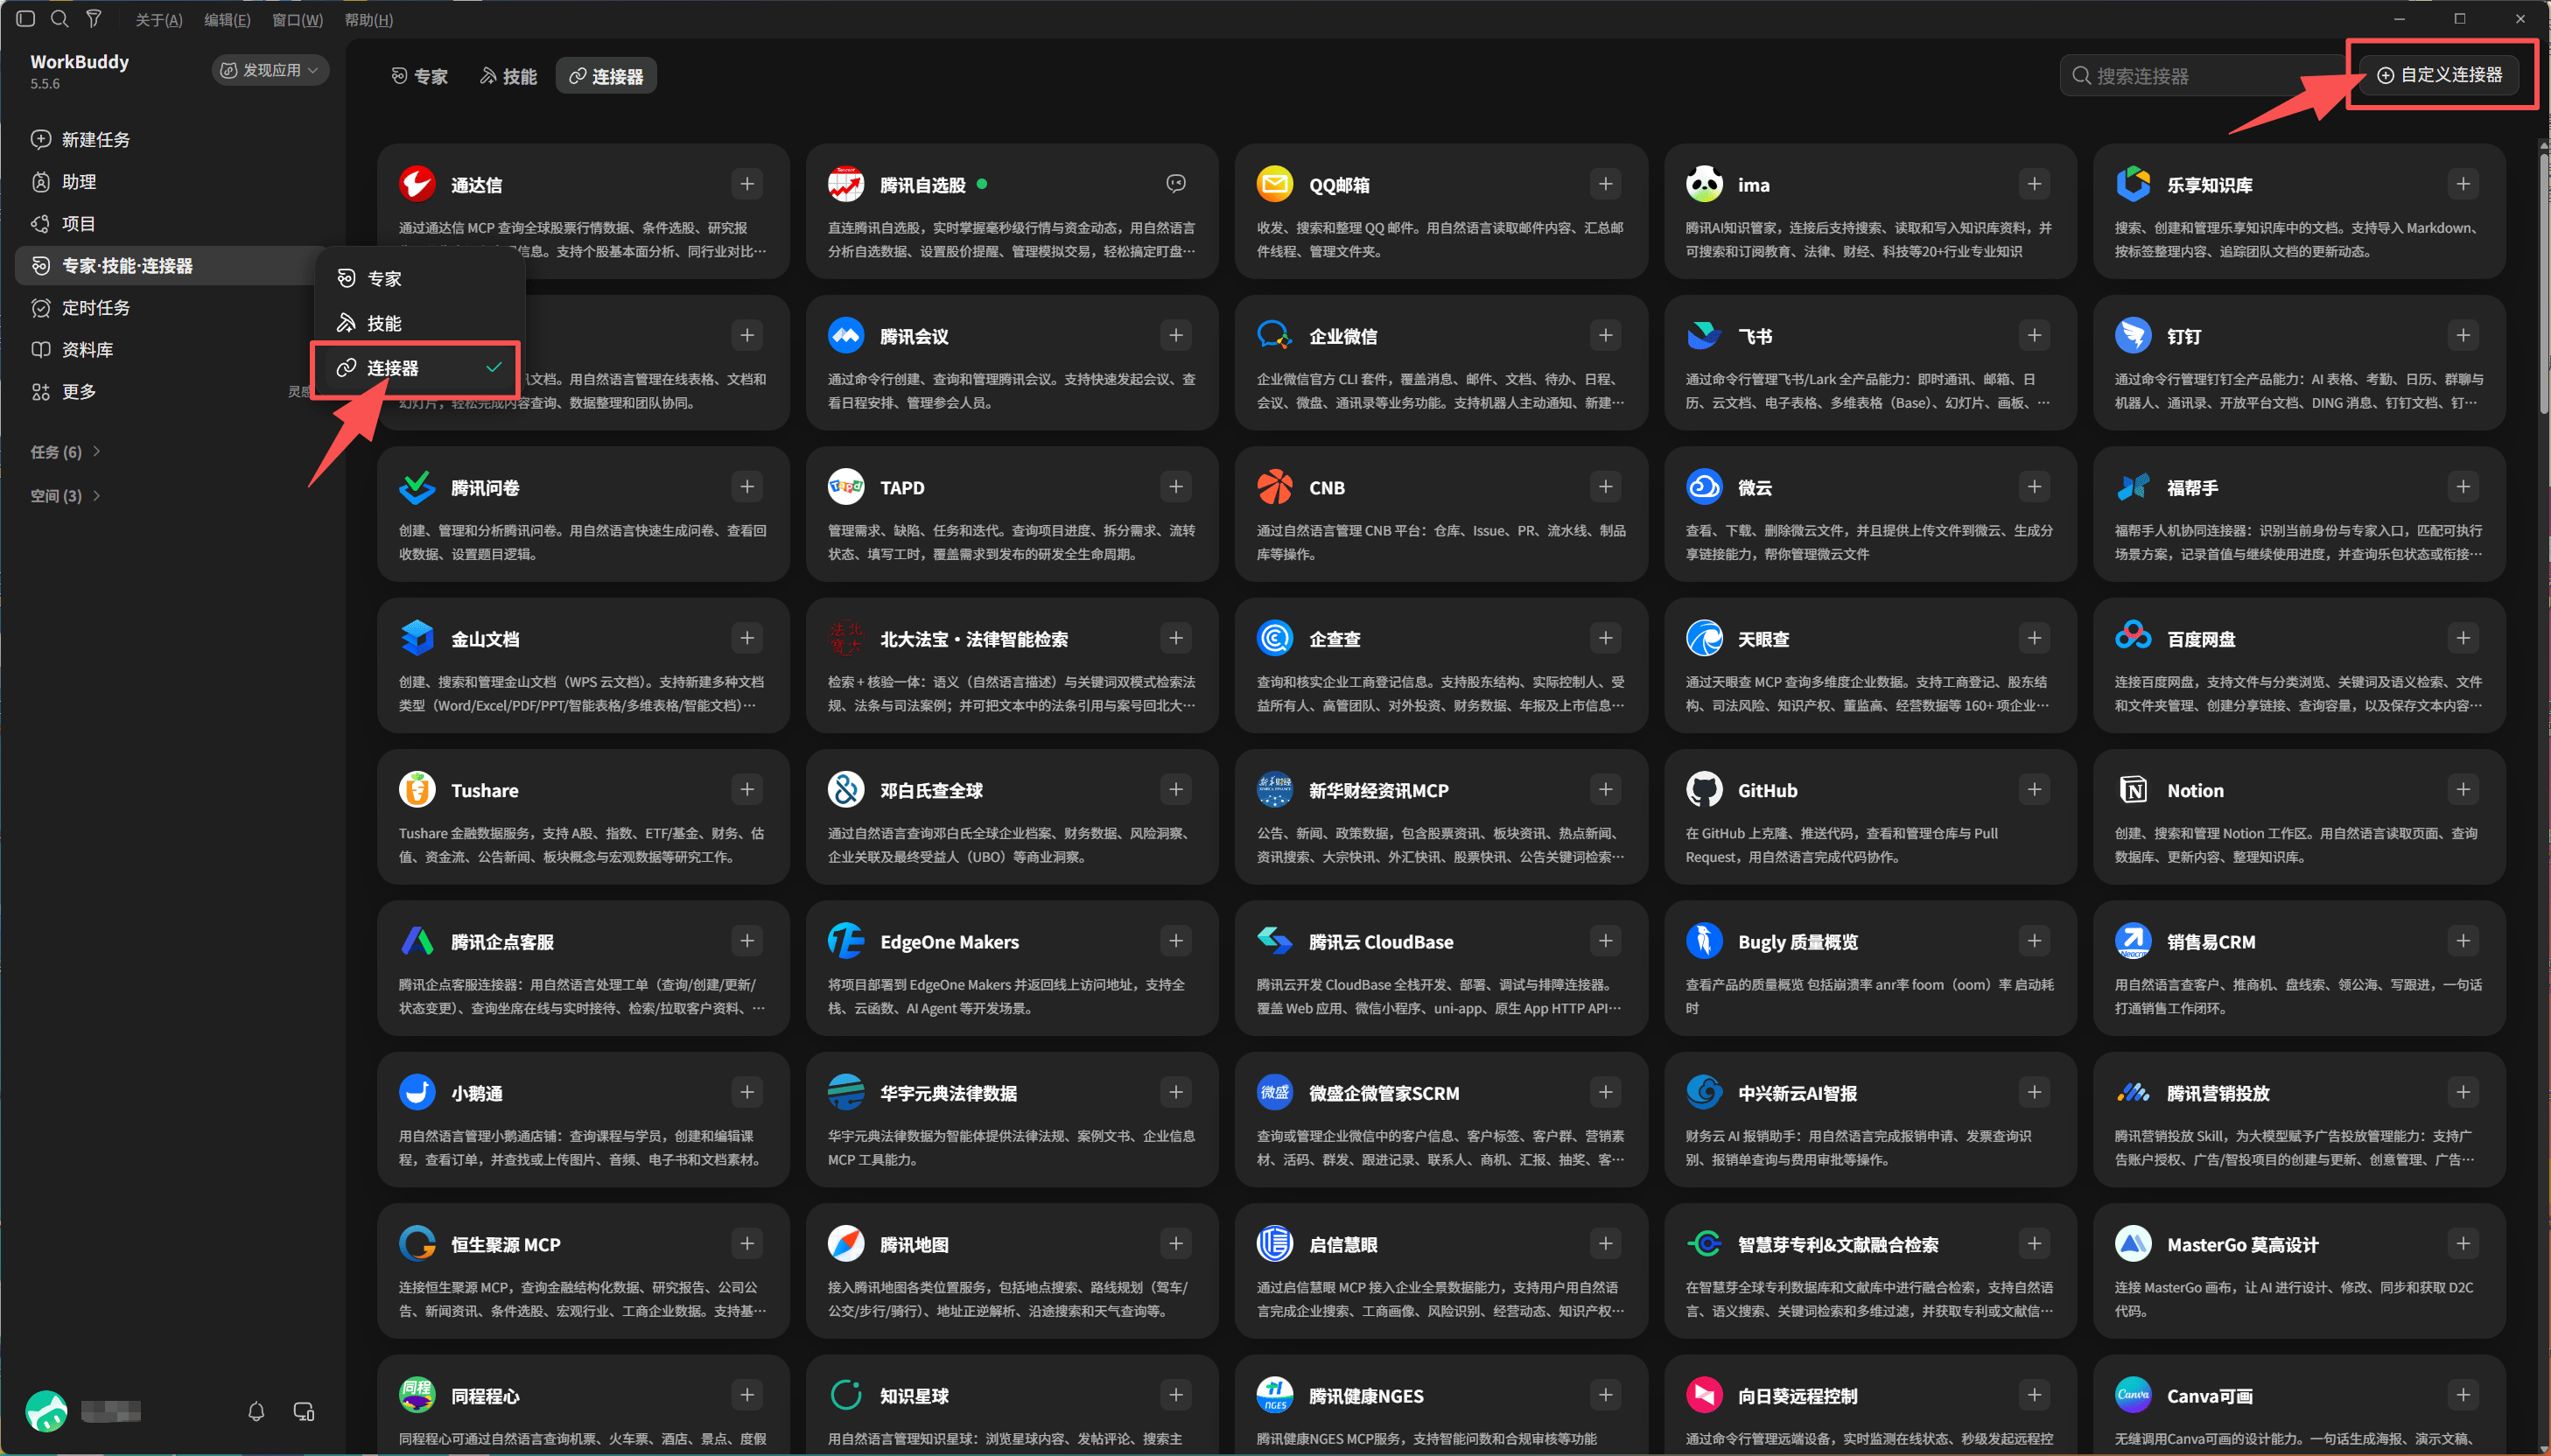
图表 10WorkBuddy 左侧边栏「专家 · 技能 · 连接器」→「连接器」,点击右上角「自定义连接」 -
3
贴配置:把下面这段 JSON 粘贴进配置框(把
sk-xxx换成你刚获取的 Key)后保存,保存即完成鉴权配置;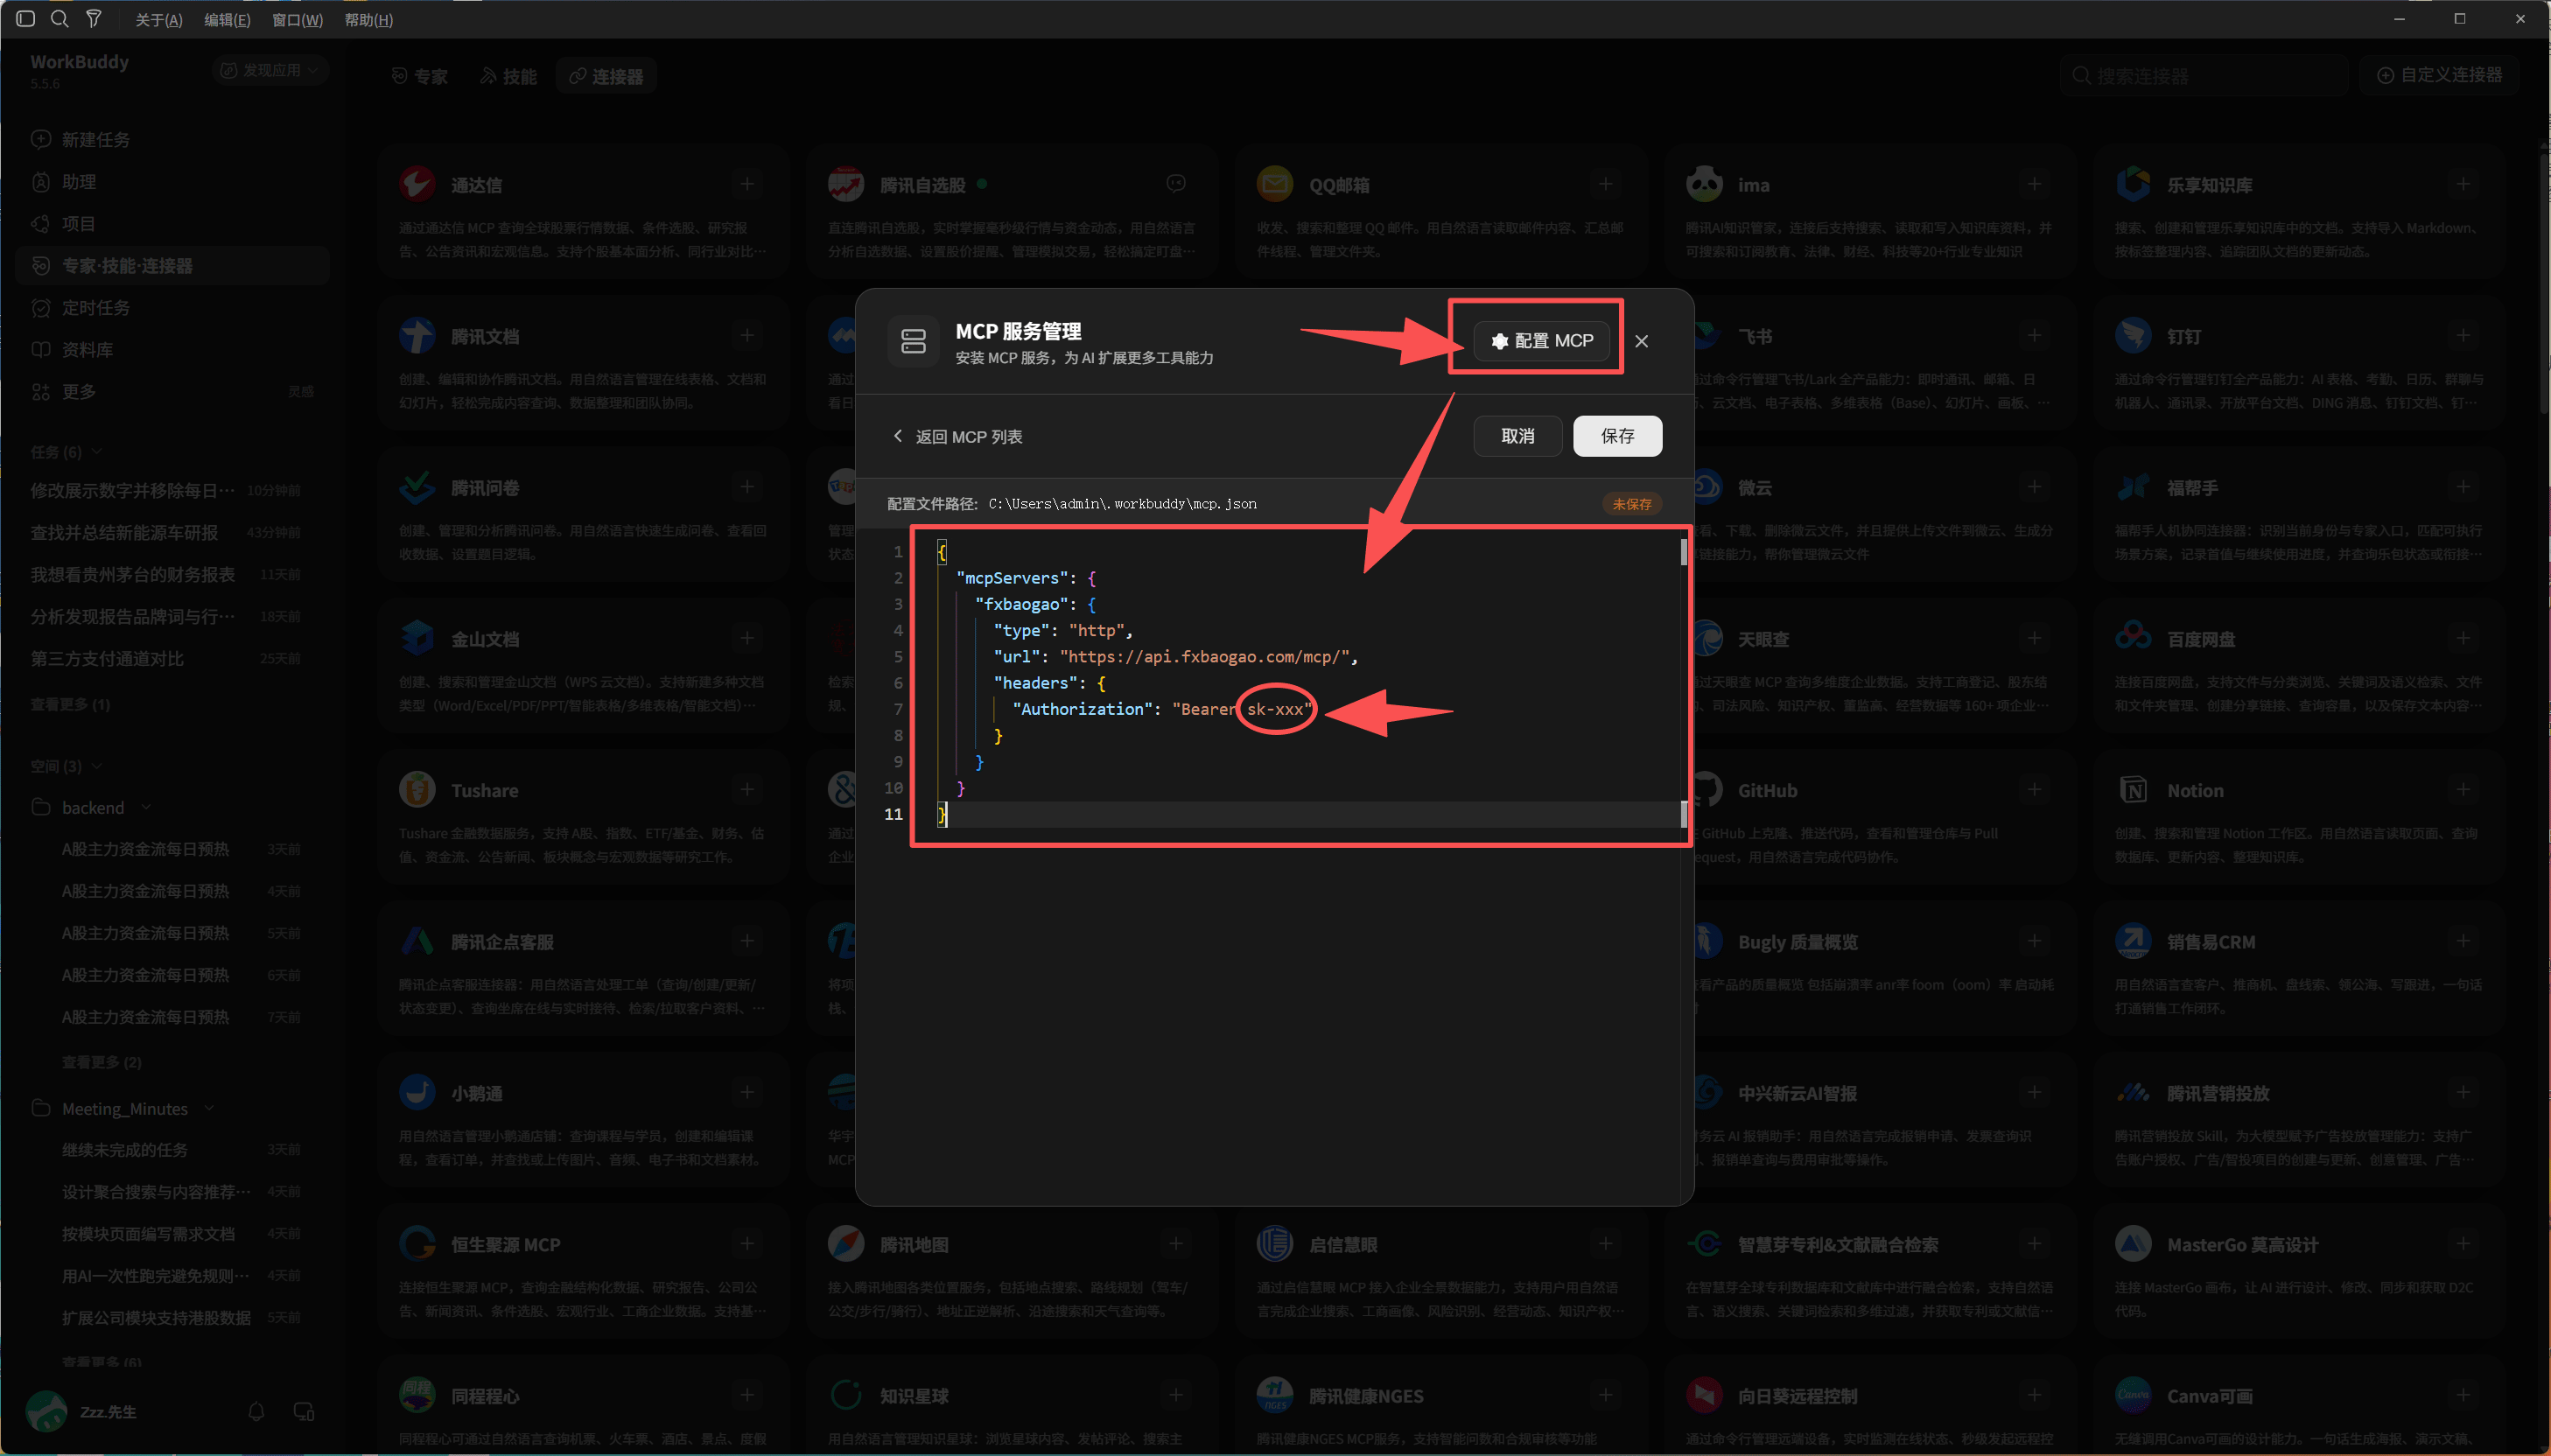
图表 11「MCP 服务管理 → 配置 MCP」中粘贴 JSON,把 sk-xxx换成你复制的 Key,点击「保存」
配置保存在本机,API Key 不会进入对话内容、也不会传给模型厂商。MCP 方式需要预先填好 Key 才能连通,保存后长期有效,一次配置所有项目复用。下载 PDF 会扣减发现报告下载权益,请按需调用。
-
4
确认启用:保存后回到「MCP 服务管理」的「我的 MCP」列表,确认
fxbaogao开关为打开状态,显示「对 3 个工具已启用」,展开可看到search_reports、get_paragraphs、get_pdf_url;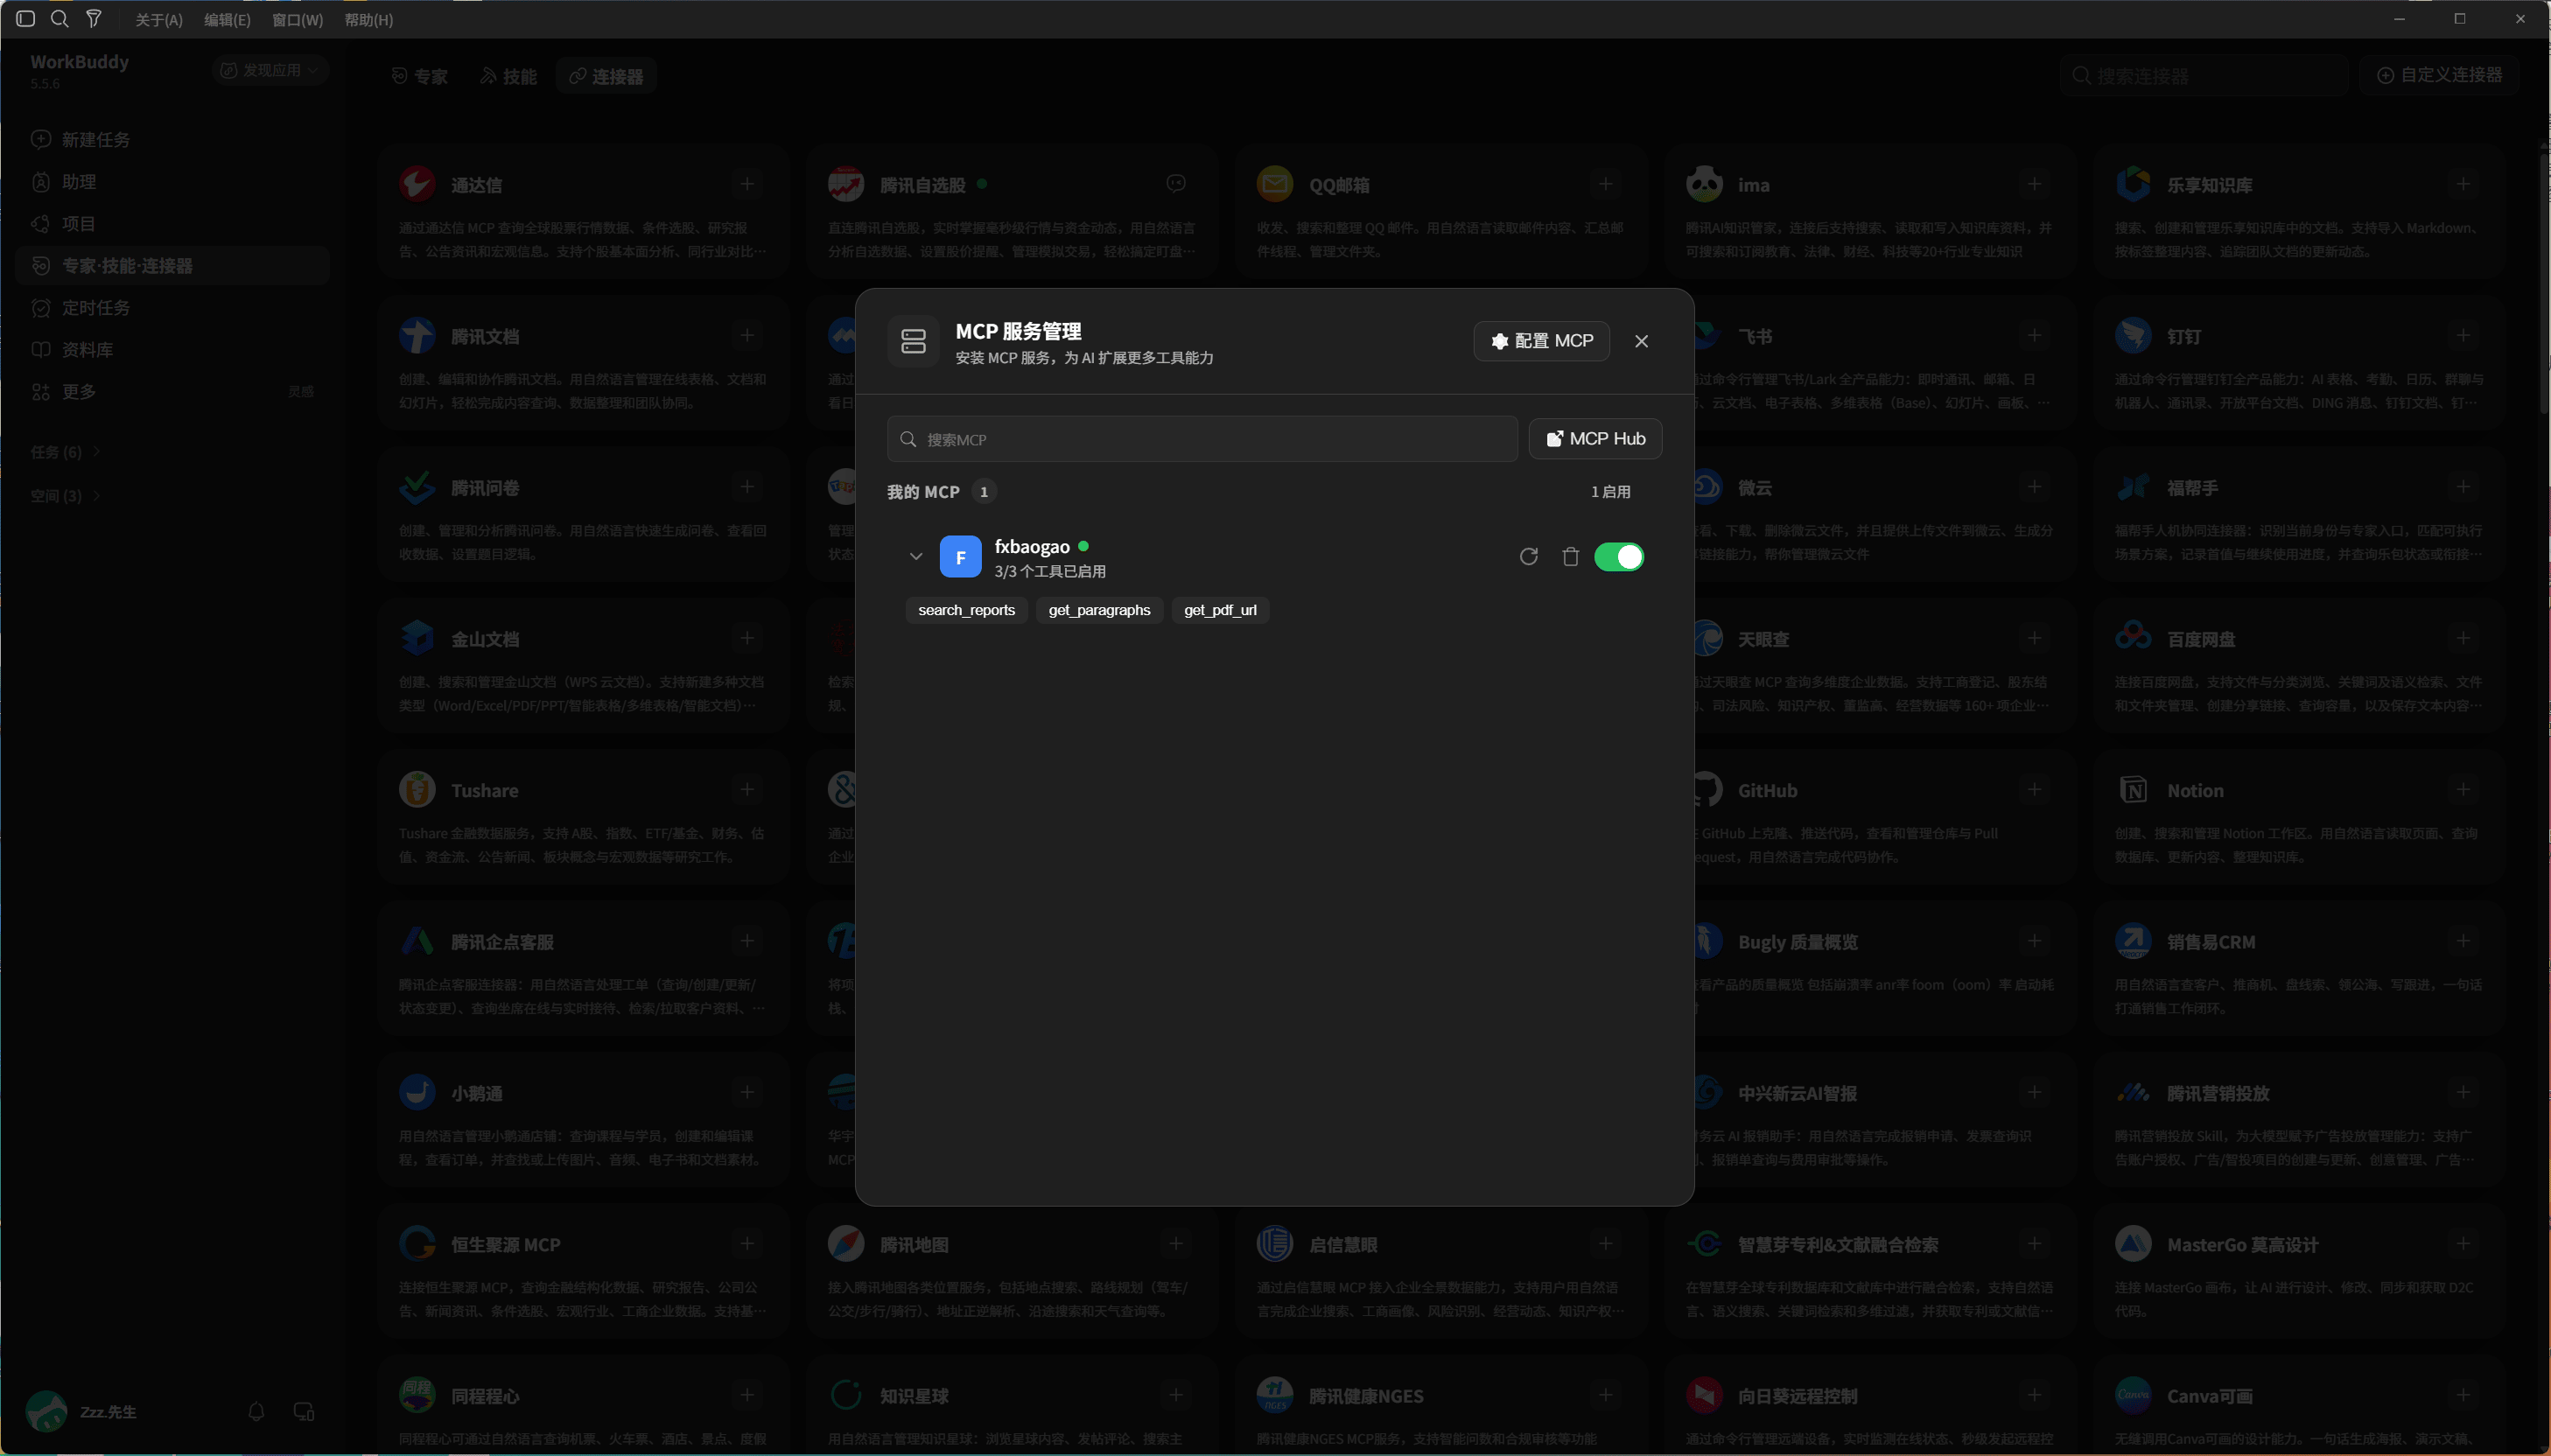
图表 12保存后回到「我的 MCP」:fxbaogao 显示「对 3 个工具已启用」,展开可见 search_reports、get_paragraphs、get_pdf_url -
5
开始用:新建对话,直接用自然语言下指令即可,例如:「搜索近一周新能源车行业评分最高的研报,总结前两篇的核心观点,并列出报告 ID 与阅读链接。」Agent 会自主完成检索、精读、汇总,全程在对话里完成。
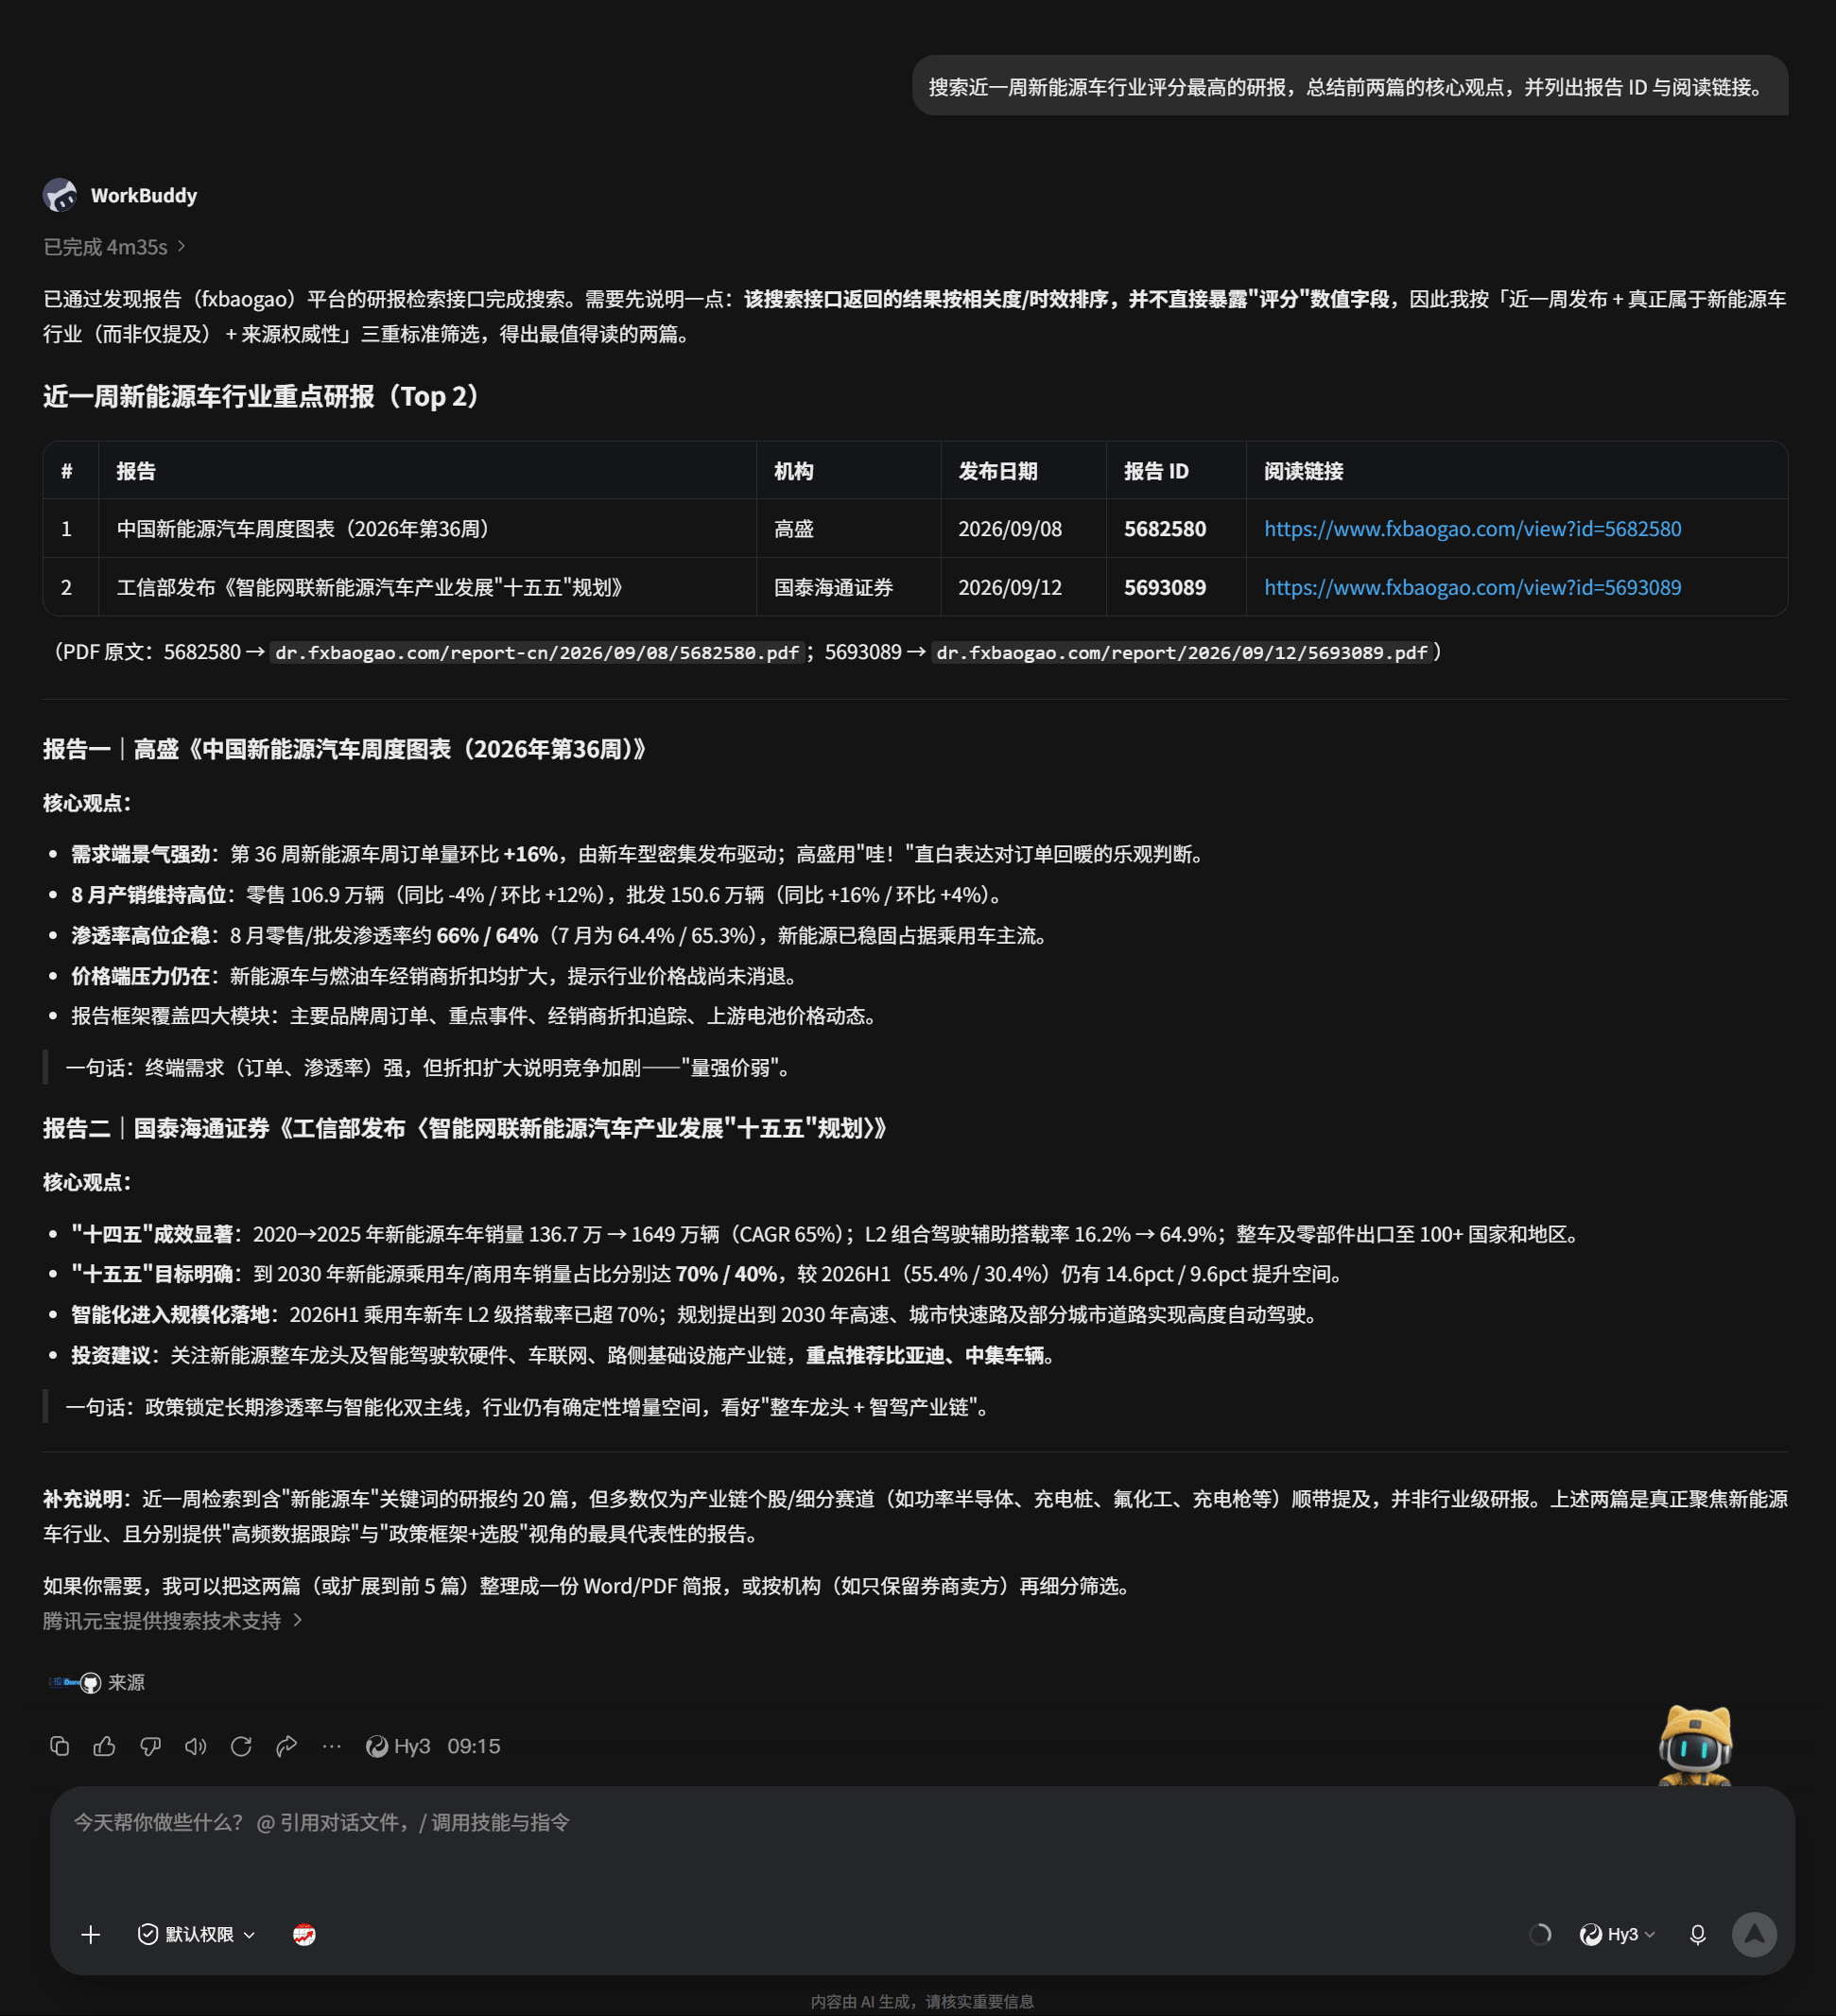
图表 13对话直接下达指令,WorkBuddy 自动检索并汇总:重点研报 Top 2 附机构、报告 ID 与阅读链接,每篇给出核心观点
启用「发现报告」技能
比 MCP 更省事的路径:无需手动编写任何配置,把官方 Skill 安装指令发给 AI,由 AI 自行下载、审计并安装到客户端;授权走发现报告官方网页授权流程,登录即完成,API Key 只保存在本机。
-
1
发安装指令:新建对话,把下面这段安装指令发给 AI(可直接复制)—— AI 会自动下载官方 Skill 包、完成安全审计,并解压安装到当前客户端的 skills 目录,无需手动操作;方式 B · 技能安装指令(复制后发给 AI)请帮我安装发现报告深度研究 Skill。 Skill zip 包地址: https://static.fxbaogao.com/pub/skills/fxbaogao-deep-research.zip 请下载、解压并安装到当前 AI 客户端的 skills 目录。 安装完成后,请阅读文档引导我完成发现报告账号授权。
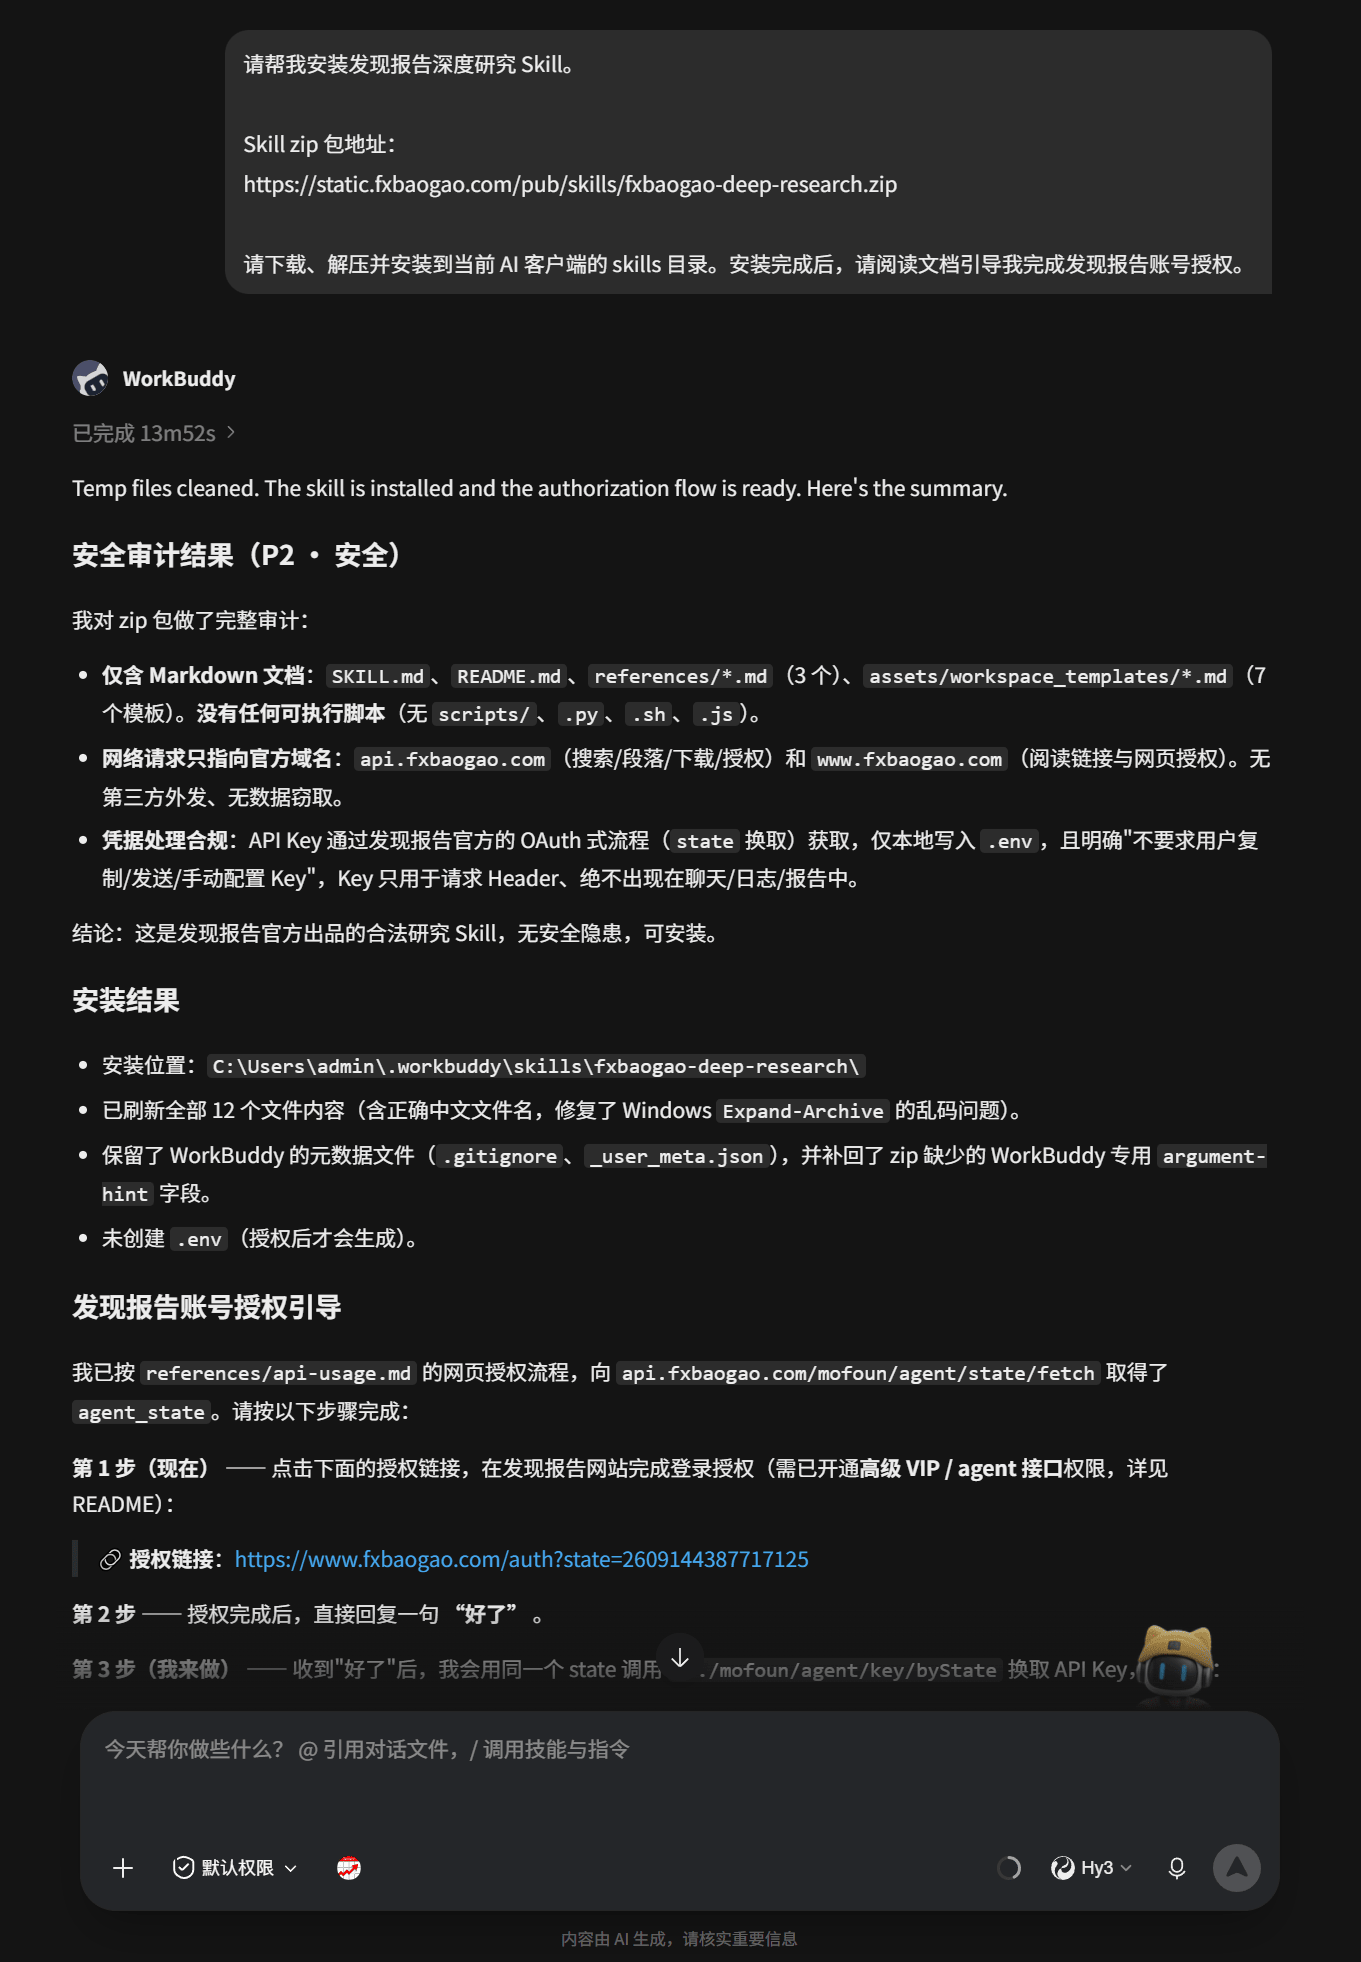
图表 14发送安装指令后,WorkBuddy 自动完成下载、安全审计与安装,并给出「发现报告账号授权引导」与授权链接 -
2
完成授权:安装完成后,AI 会按文档发起账号授权 —— 点击它给出的授权链接,在发现报告网站完成登录授权(需已开通高级 VIP / agent 接口权限),回到对话回复「好了」,AI 即自动换取 API Key 并保存到本机,全程无需手动复制 Key;也可改为自取 Key:到用户中心复制
API Key按提示提供。授权一次长期有效;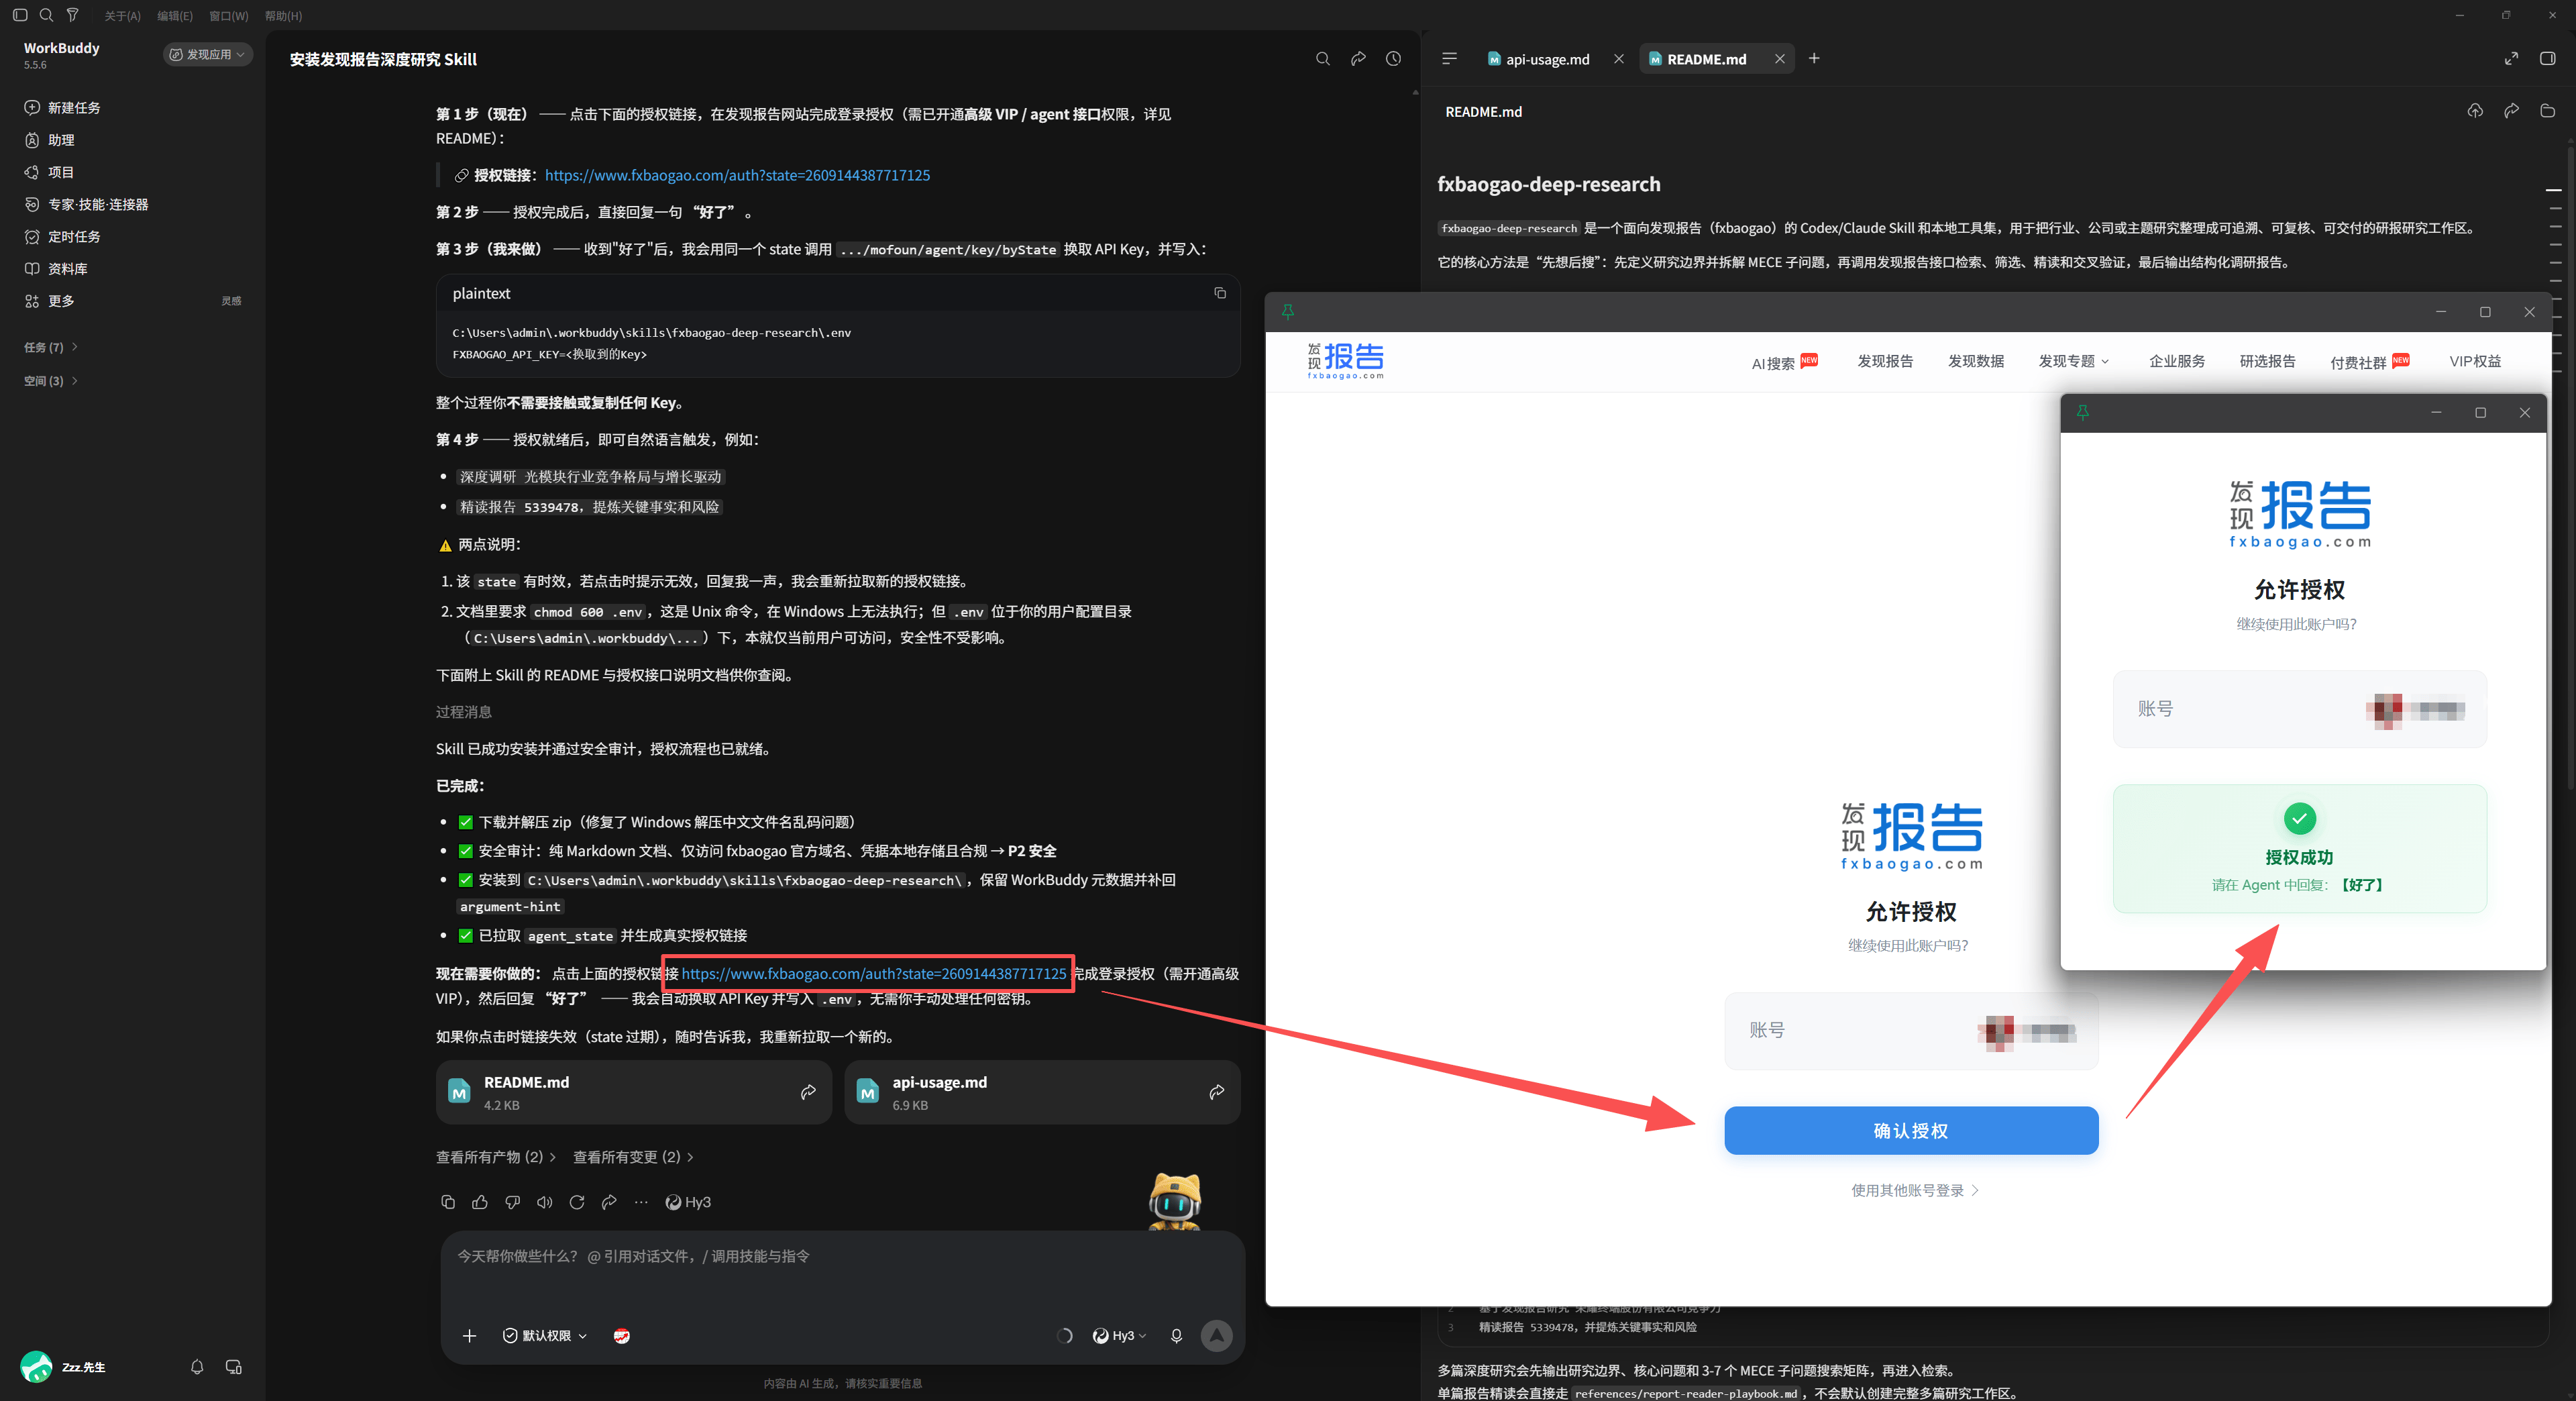
图表 15点击 AI 给出的授权链接,打开发现报告授权页点「确认授权」;弹窗提示「授权成功」后,回到对话回复「好了」,AI 即自动换取 API Key 并保存到本机 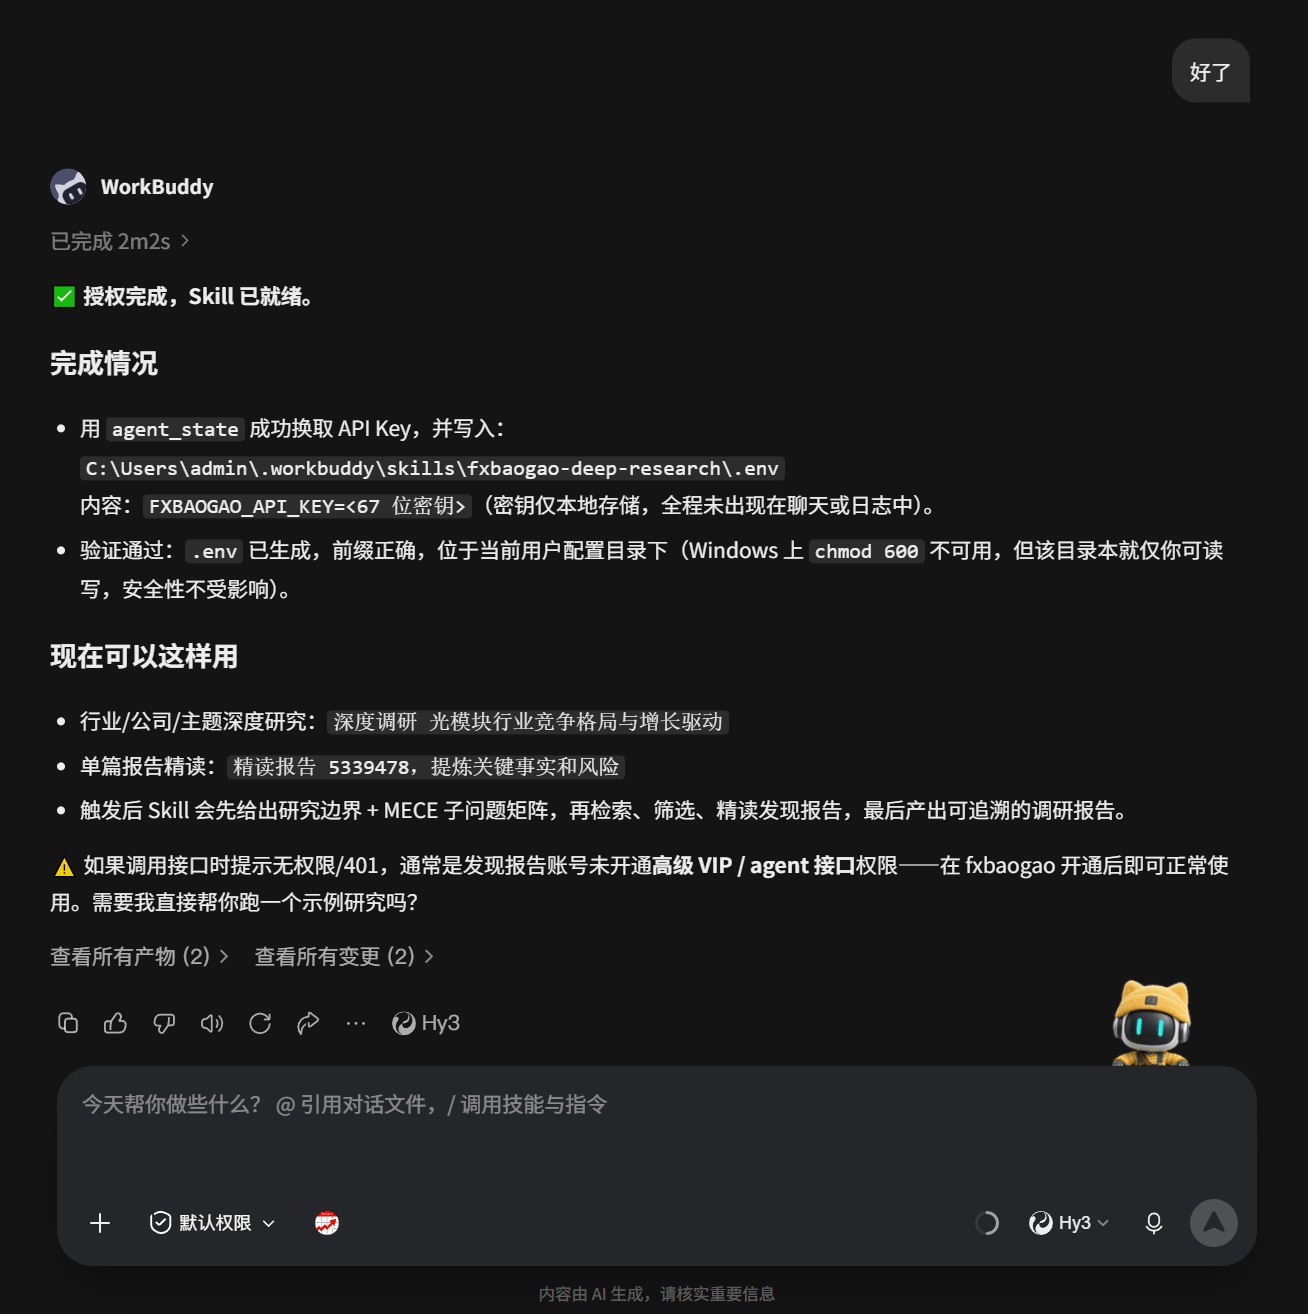
图表 16回到对话回复「好了」,AI 自动换取 API Key 并写入技能目录的 .env(密钥仅存本机),提示「授权完成,Skill 已就绪」 -
3
对话触发:新建对话,直接说需求即可。技能会先给出研究边界与子问题矩阵,再自动完成检索、筛选与精读,全程无需手动指定工具。不知道第一句说什么?下面三个问题由浅入深,复制进去就能跑:问题 1 单篇精读
「精读报告 5339478,提炼关键事实、核心数据和风险点,输出一页速览笔记。」
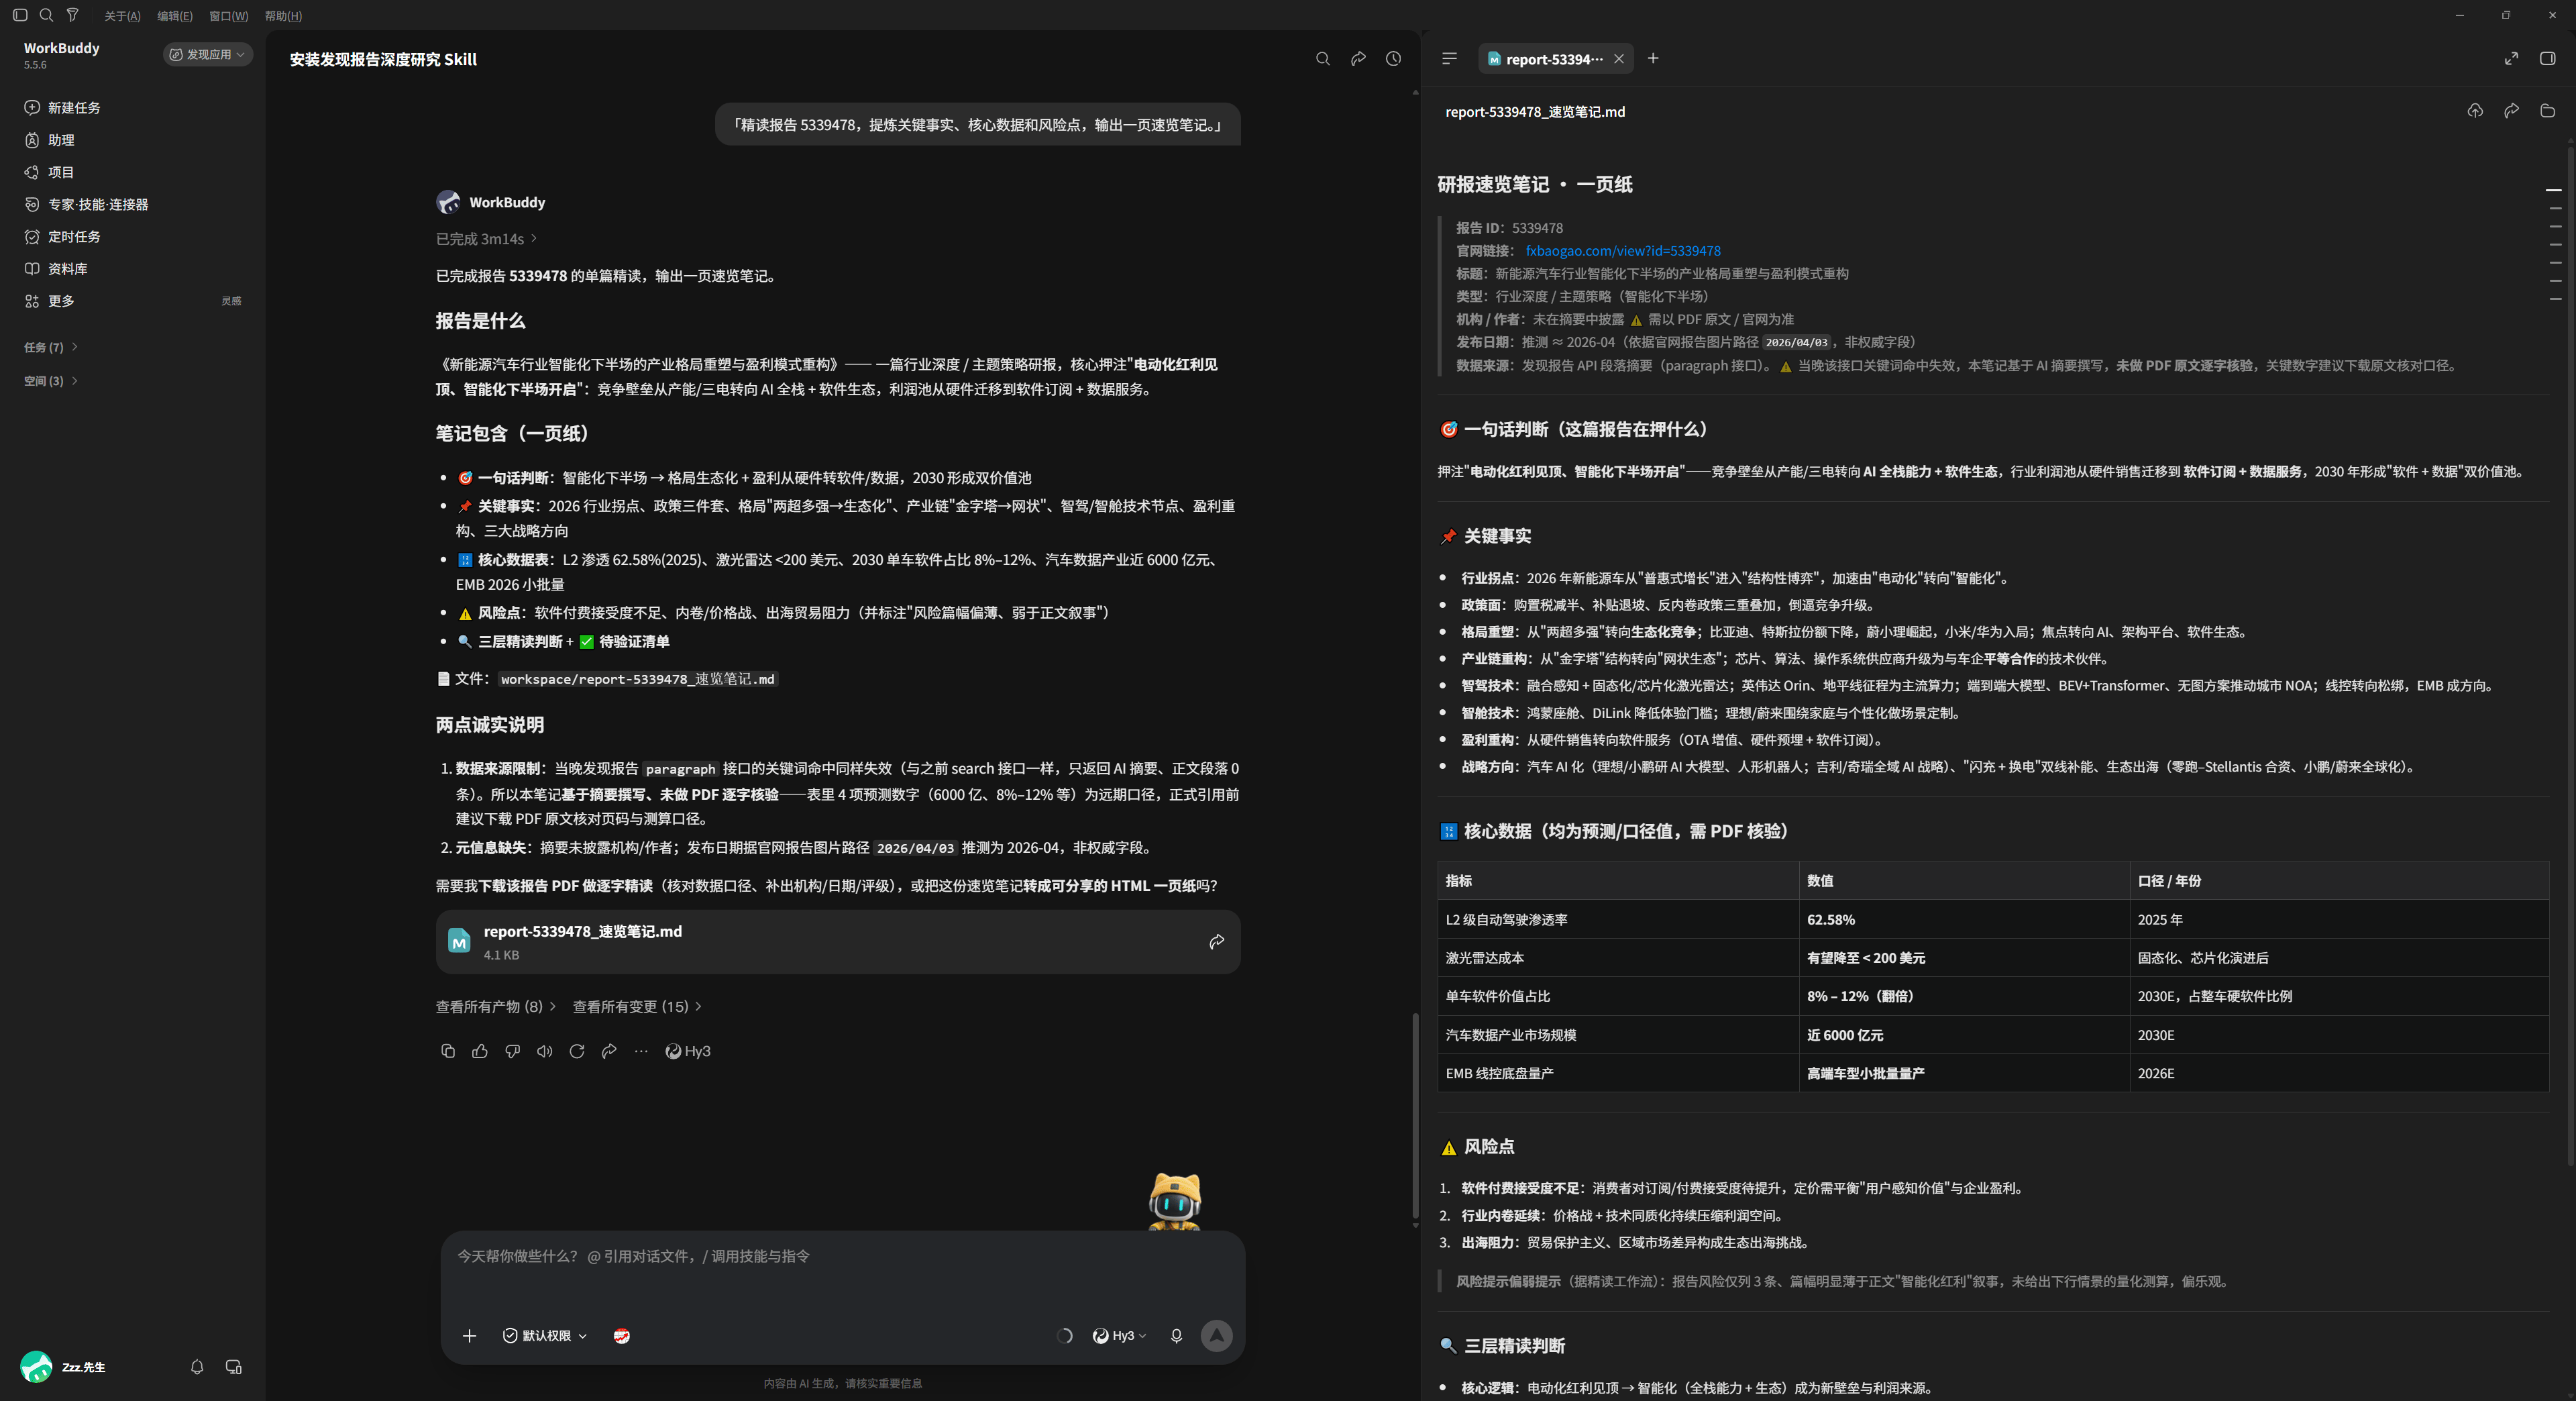
图表 17把上面的问题发给 Skill:自动定位报告 5339478(半导体设备行业),精读后产出《研报速览笔记 · 一页纸》——一句话判断、关键事实、核心数据表、风险点,每个结论都带原文出处可回溯 问题 2 深度调研「深度调研 光模块行业竞争格局与增长驱动,产出一份带报告 ID 引用的调研报告。」
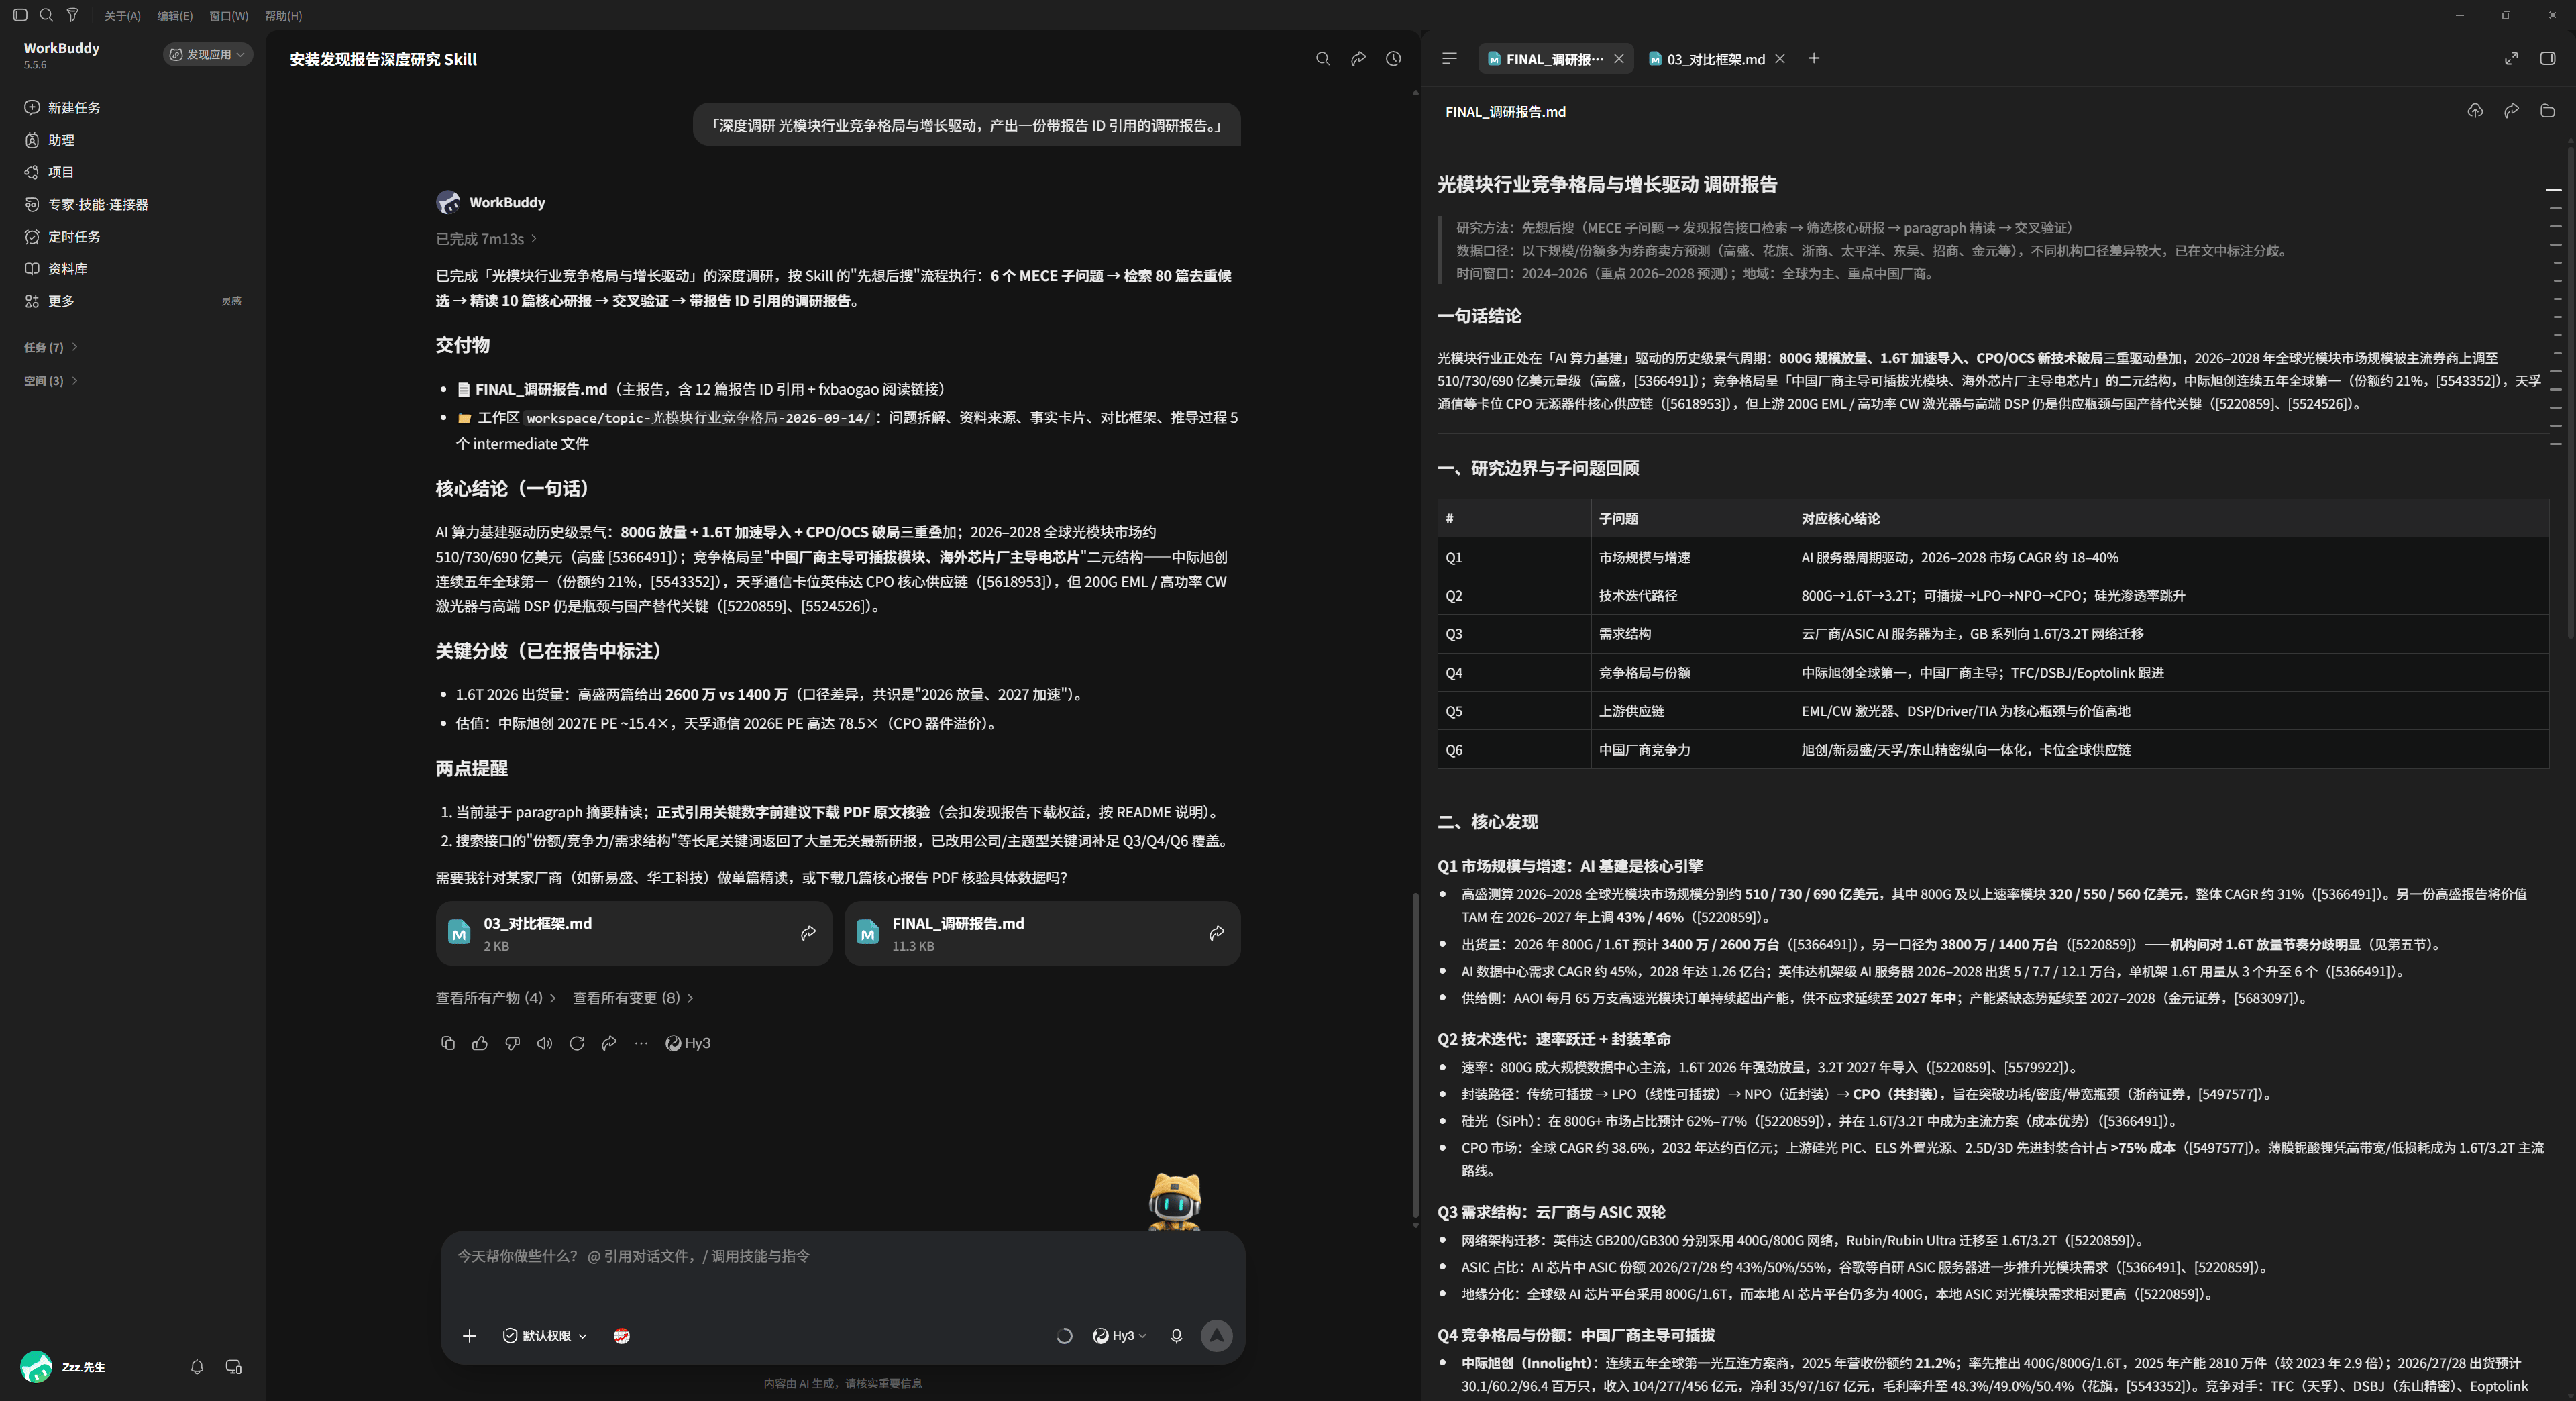
图表 18输入上面的问题后,Skill 先给出研究边界与子问题矩阵,再检索、筛选、精读,最终产出《光模块行业深度调研报告》( FINAL_调研报告.md):一句话结论、核心分歧、关键数字全部带报告 ID 可回溯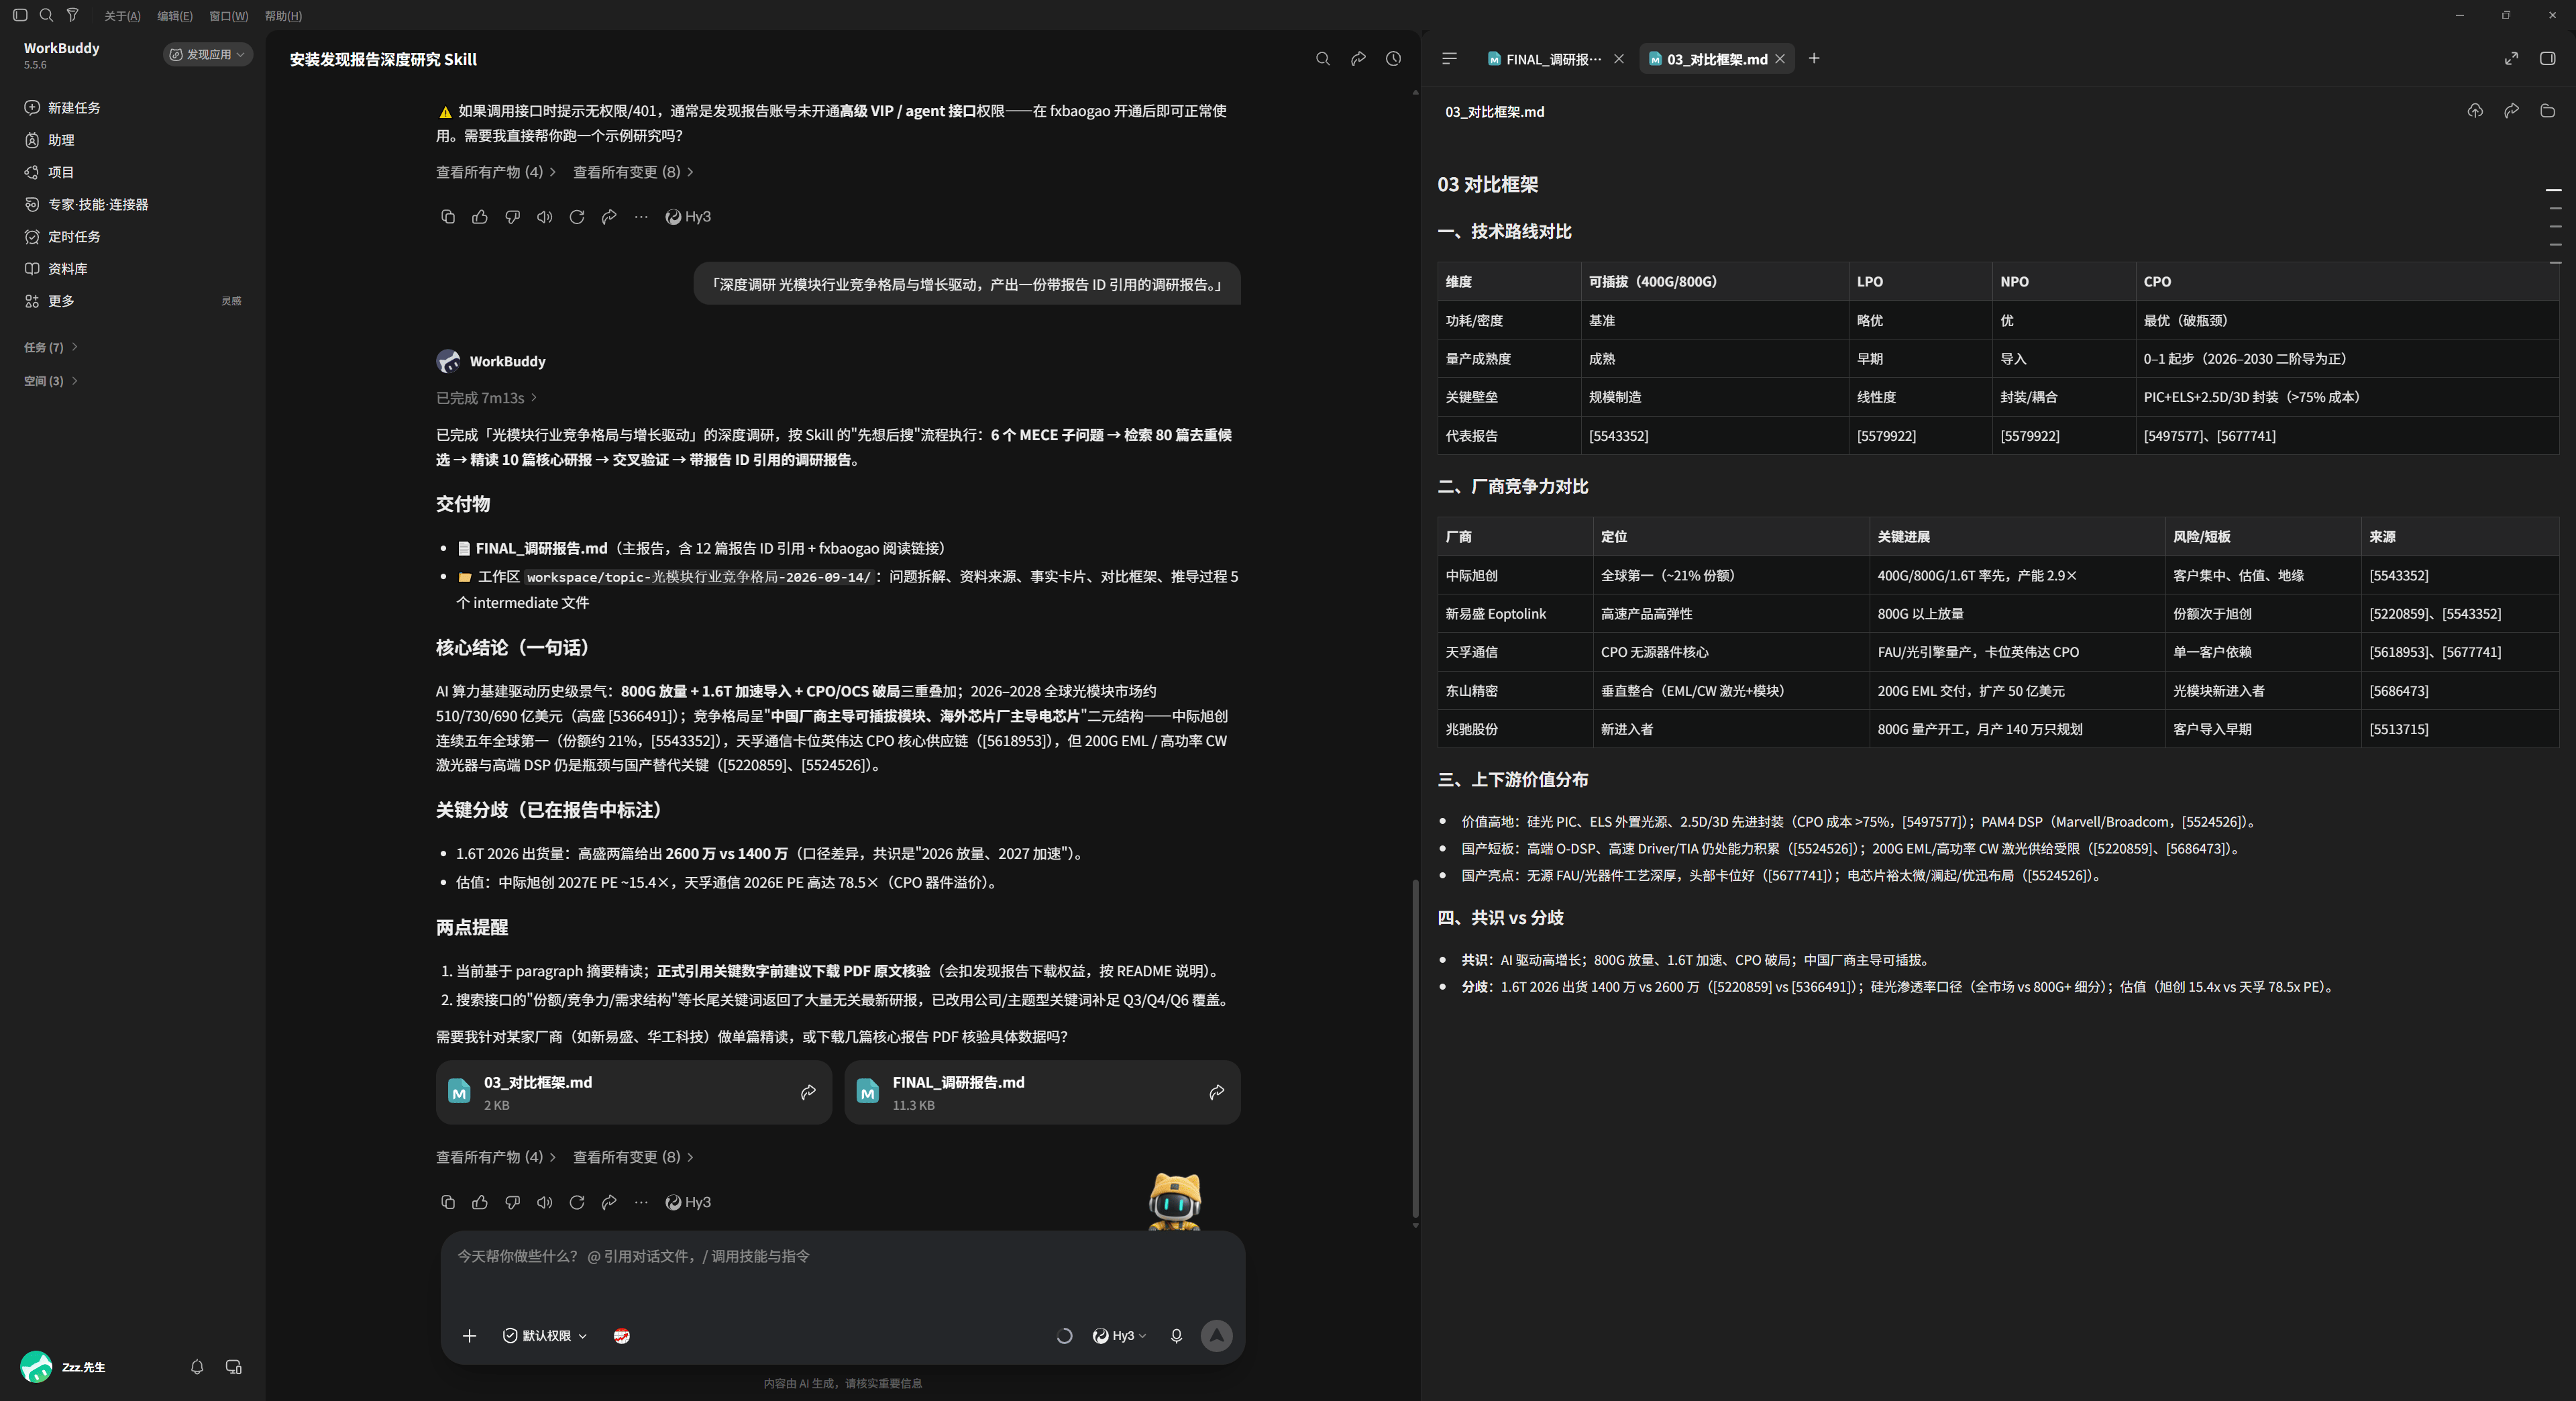
图表 19同一份指令还会产出多交付物:《 03_对比摘要.md》等技术路线、厂商竞争力、上下游价值分册 + 《FINAL_调研报告.md》总报告,按需取用问题 3 多篇对比「对比近三个月券商对固态电池产业化节奏的最新判断,标注分歧点并附报告链接。」
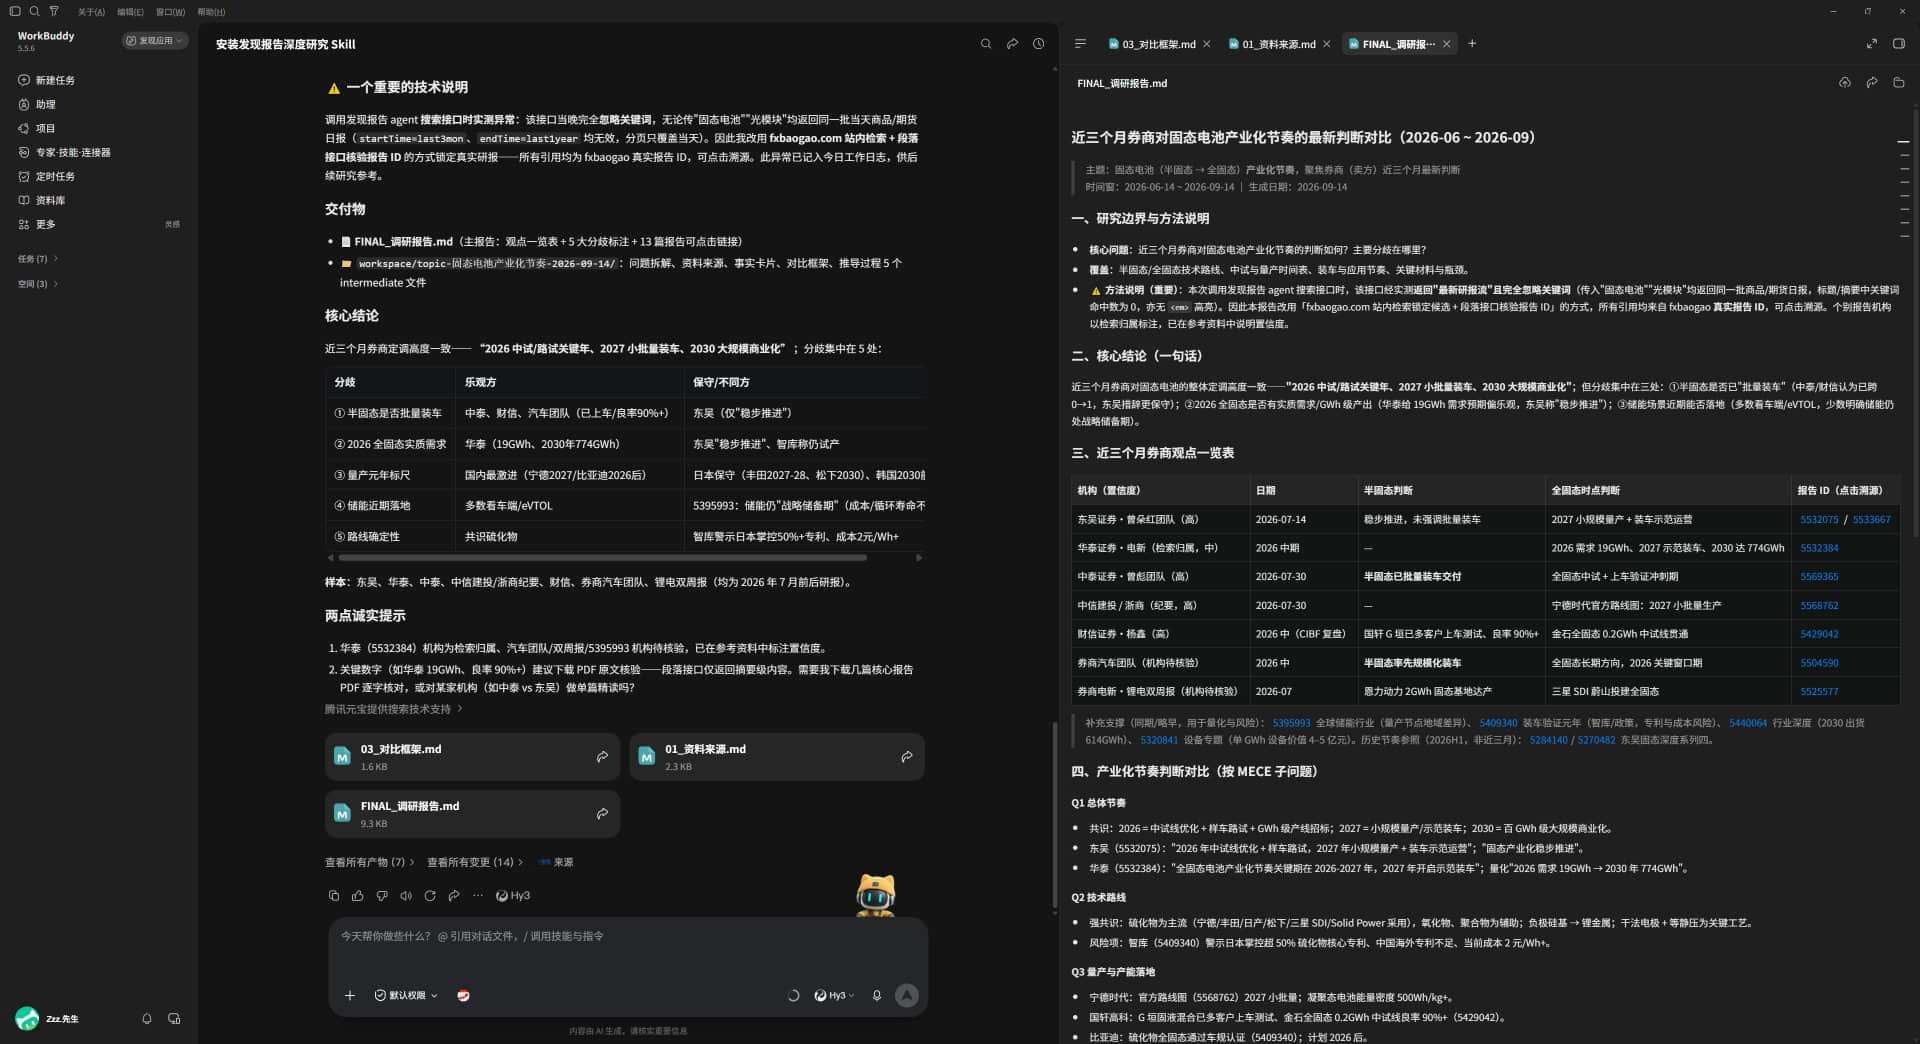
图表 20把上面的问题发给 Skill:自动检索近三个月券商研报,产出《固态电池产业化节奏券商判断对比》——分歧拆解(多方 vs 保守方)、周度证据提示,交付物含 FINAL_调研报告.md、03_对比摘要.md、01_材料速览.md多份文件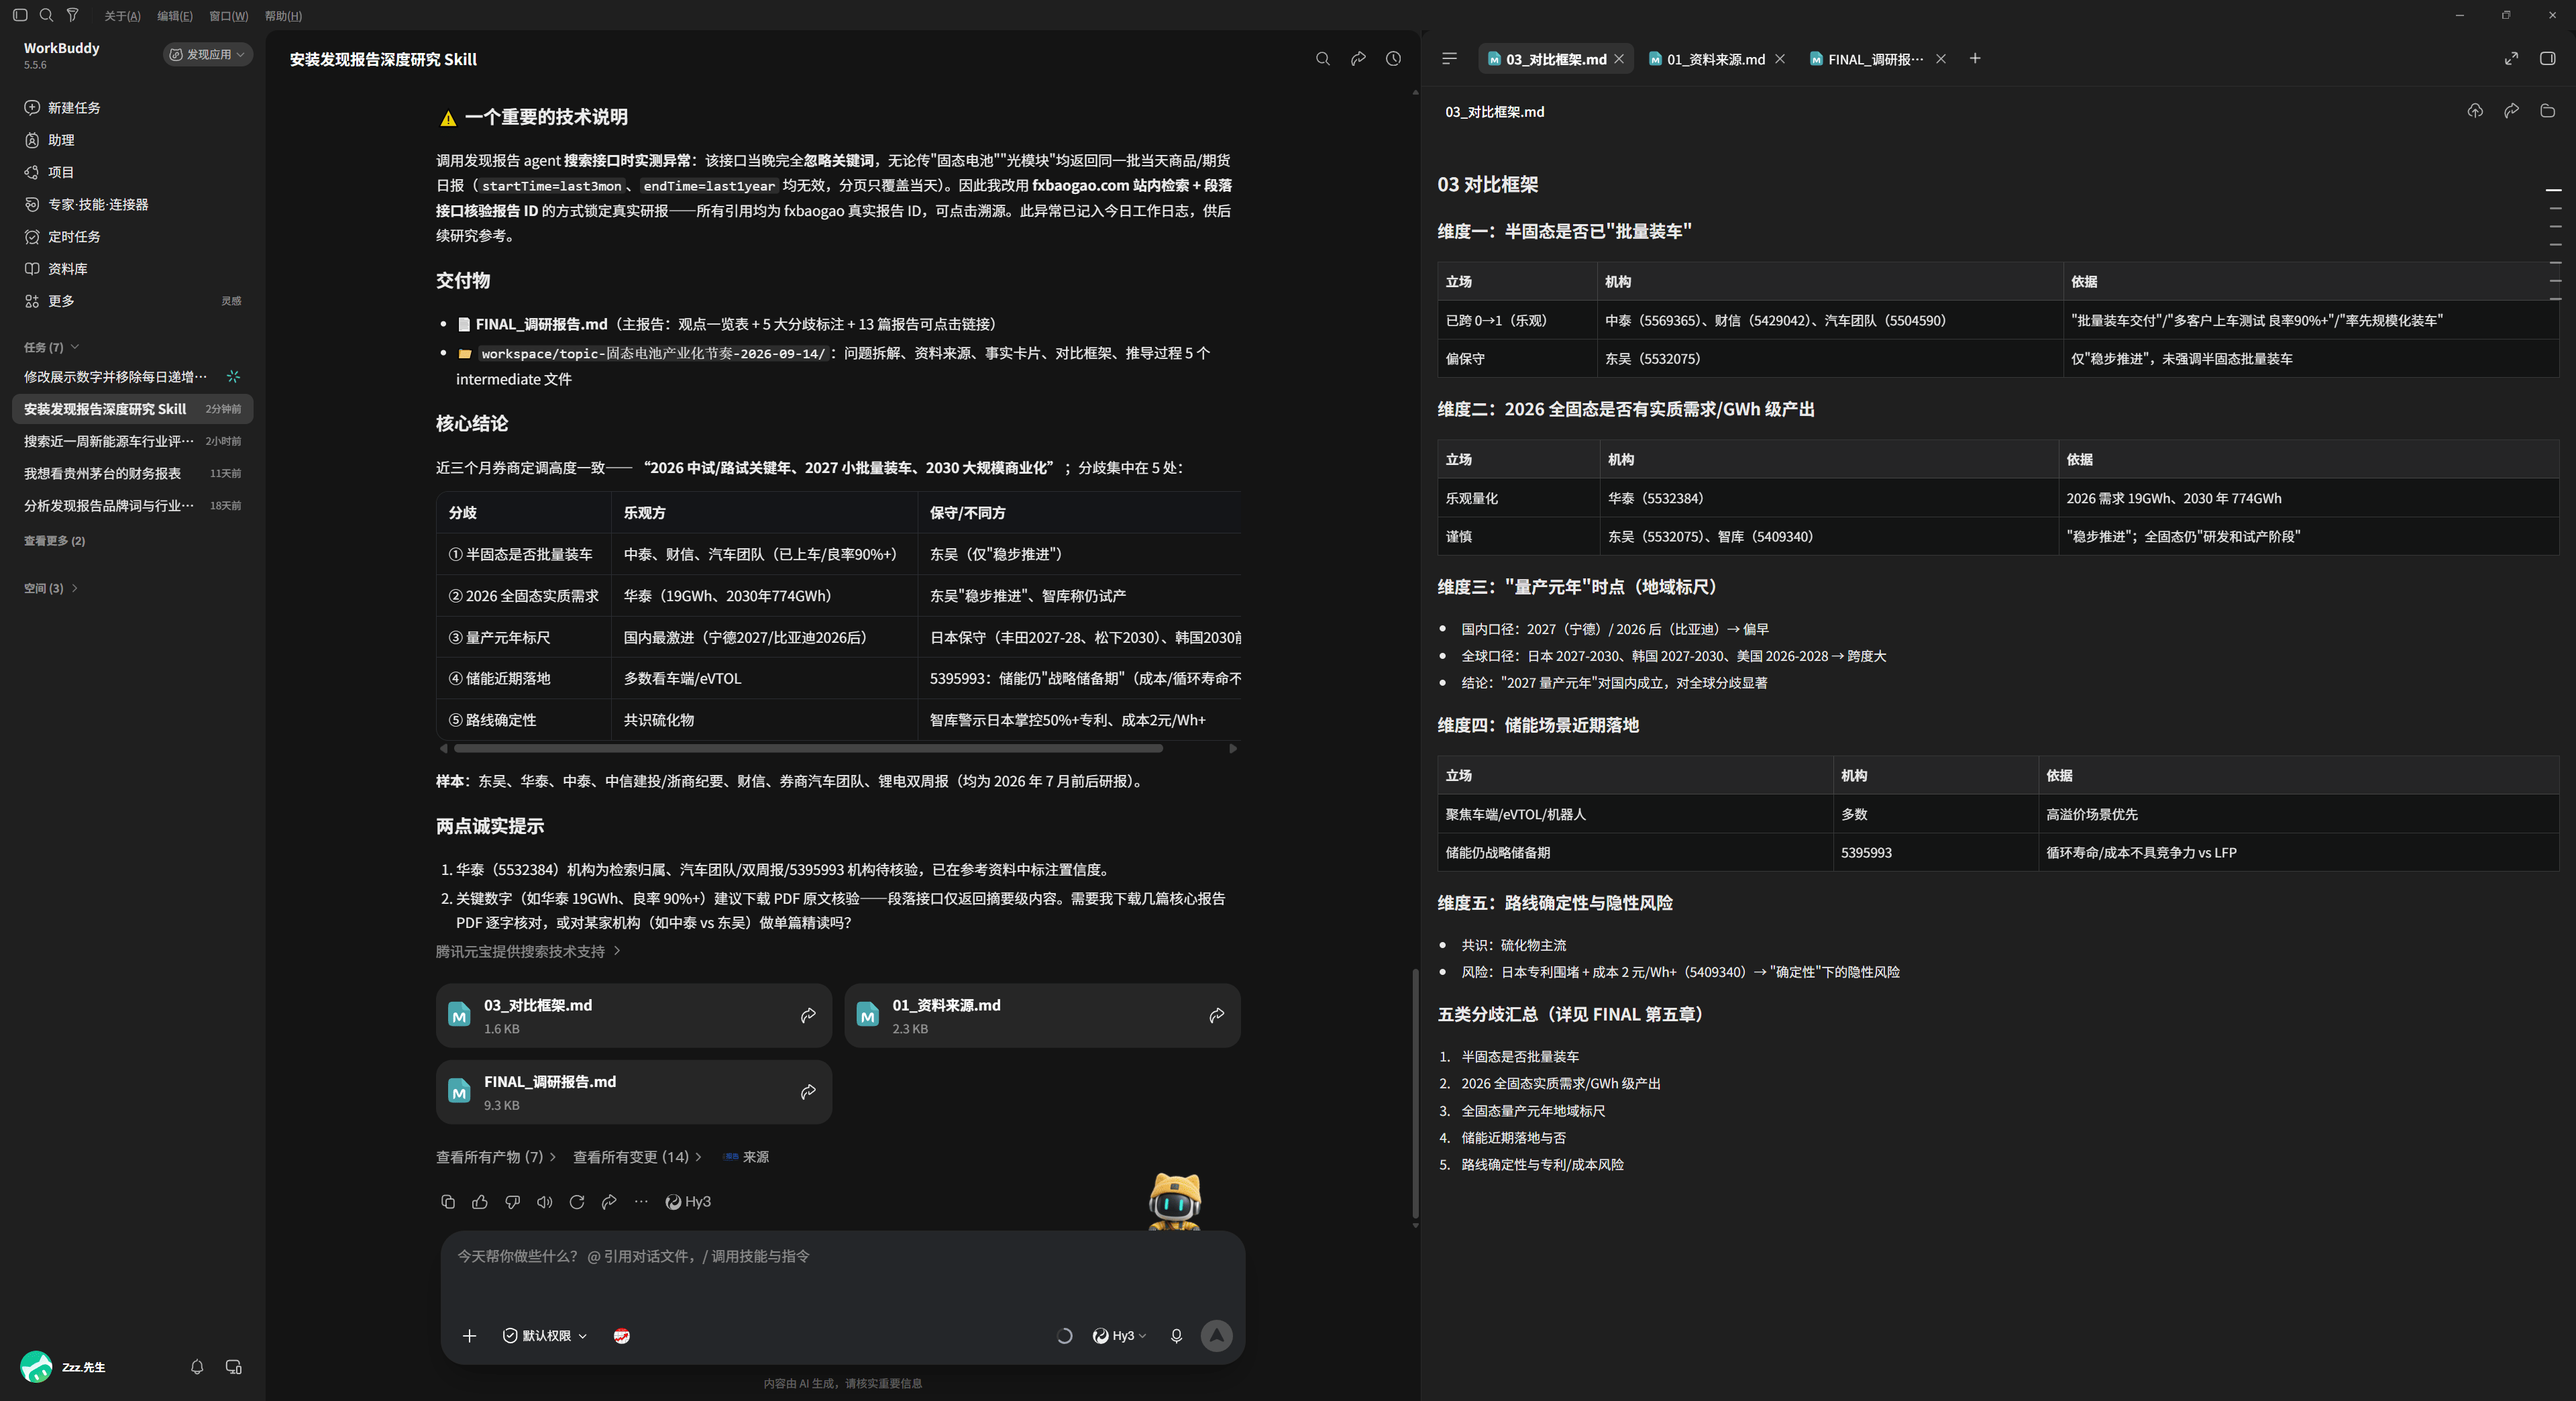
图表 21 03_对比摘要.md分册:半固态「批量装车」综述、全固态实装商用对照、量产元年候选、隐性风险与五步分析汇报索引,每条判断都附报告 ID -
4
查看结果:技能返回研报列表与核心观点摘要,附报告 ID 与阅读链接(
https://www.fxbaogao.com/view?id=<reportId>),每个结论都能回到原文核对。
图表 22报告自带证据链索引:每个主题对应核心报告,报告 ID 均为可点击链接,每个结论都能回到原文核对 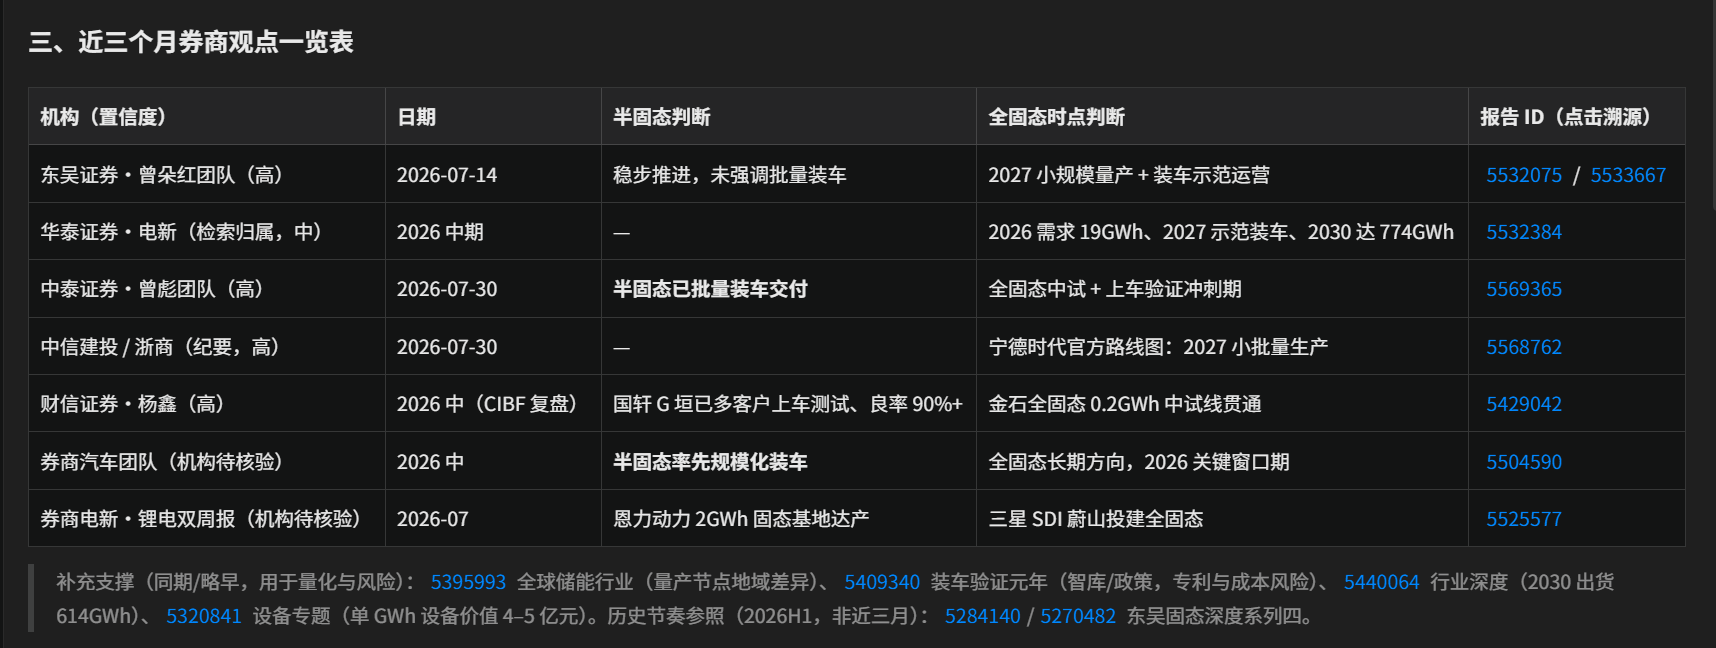
图表 23对比类指令则产出券商观点一览表:机构(置信度)、日期、核心判断、报告 ID(点击溯源)一表打尽
Skill 包由发现报告官方出品,仅从 static.fxbaogao.com 官方域名分发,安装前 AI 会自动完成安全审计;API Key 只保存在本机、不进入对话内容。若你的 AI 客户端不支持安装本地 Skill,可回到方式 A 通过 MCP 服务接入,效果一致。
指令速查 · 接好之后从这些问题开始
不知道第一句该问什么?下面 6 条指令覆盖了三个工具的典型用法,从「只用检索」到「检索 → 精读 → 取原文」全链路,复制进对话即可,把行业、机构、时间范围换成你关心的内容。
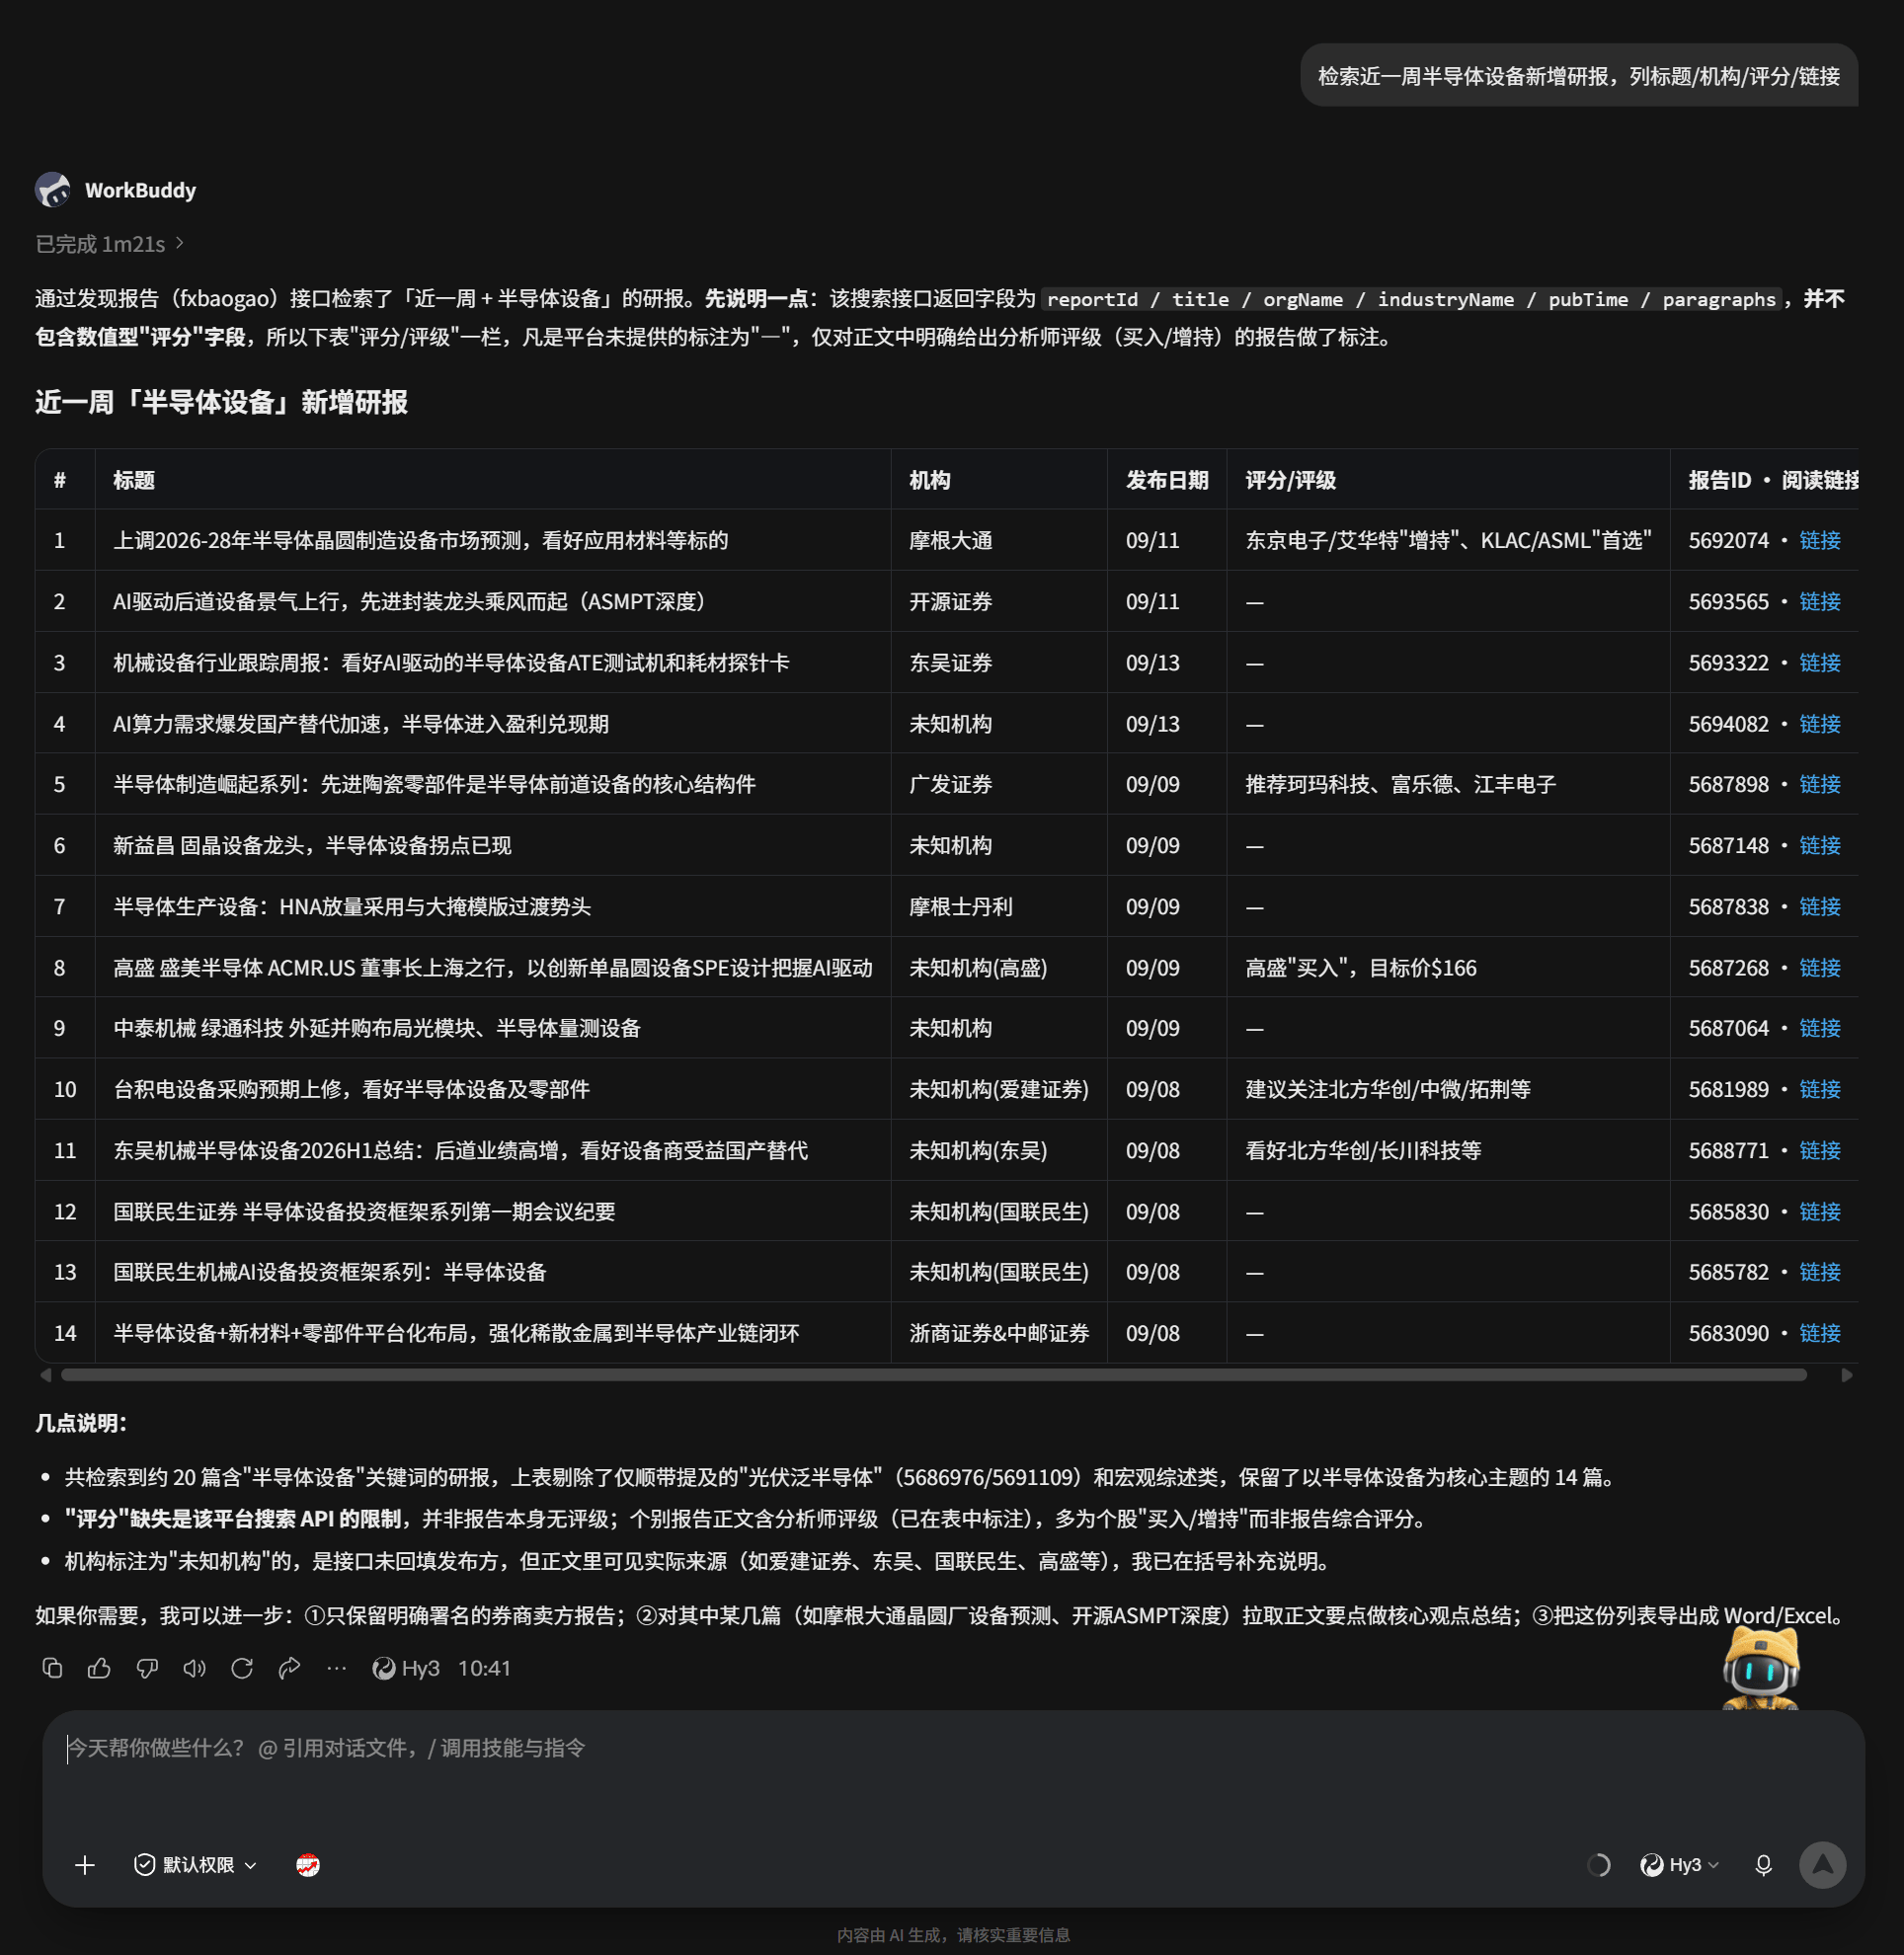
行业盘点 · 快速摸底
「检索近一周半导体设备新增研报,列标题/机构/评分/链接。」
调用:search_reports · 换行业词即可盘点任何赛道,适合每日快速过一遍新增报告
追踪机构 / 公司动向
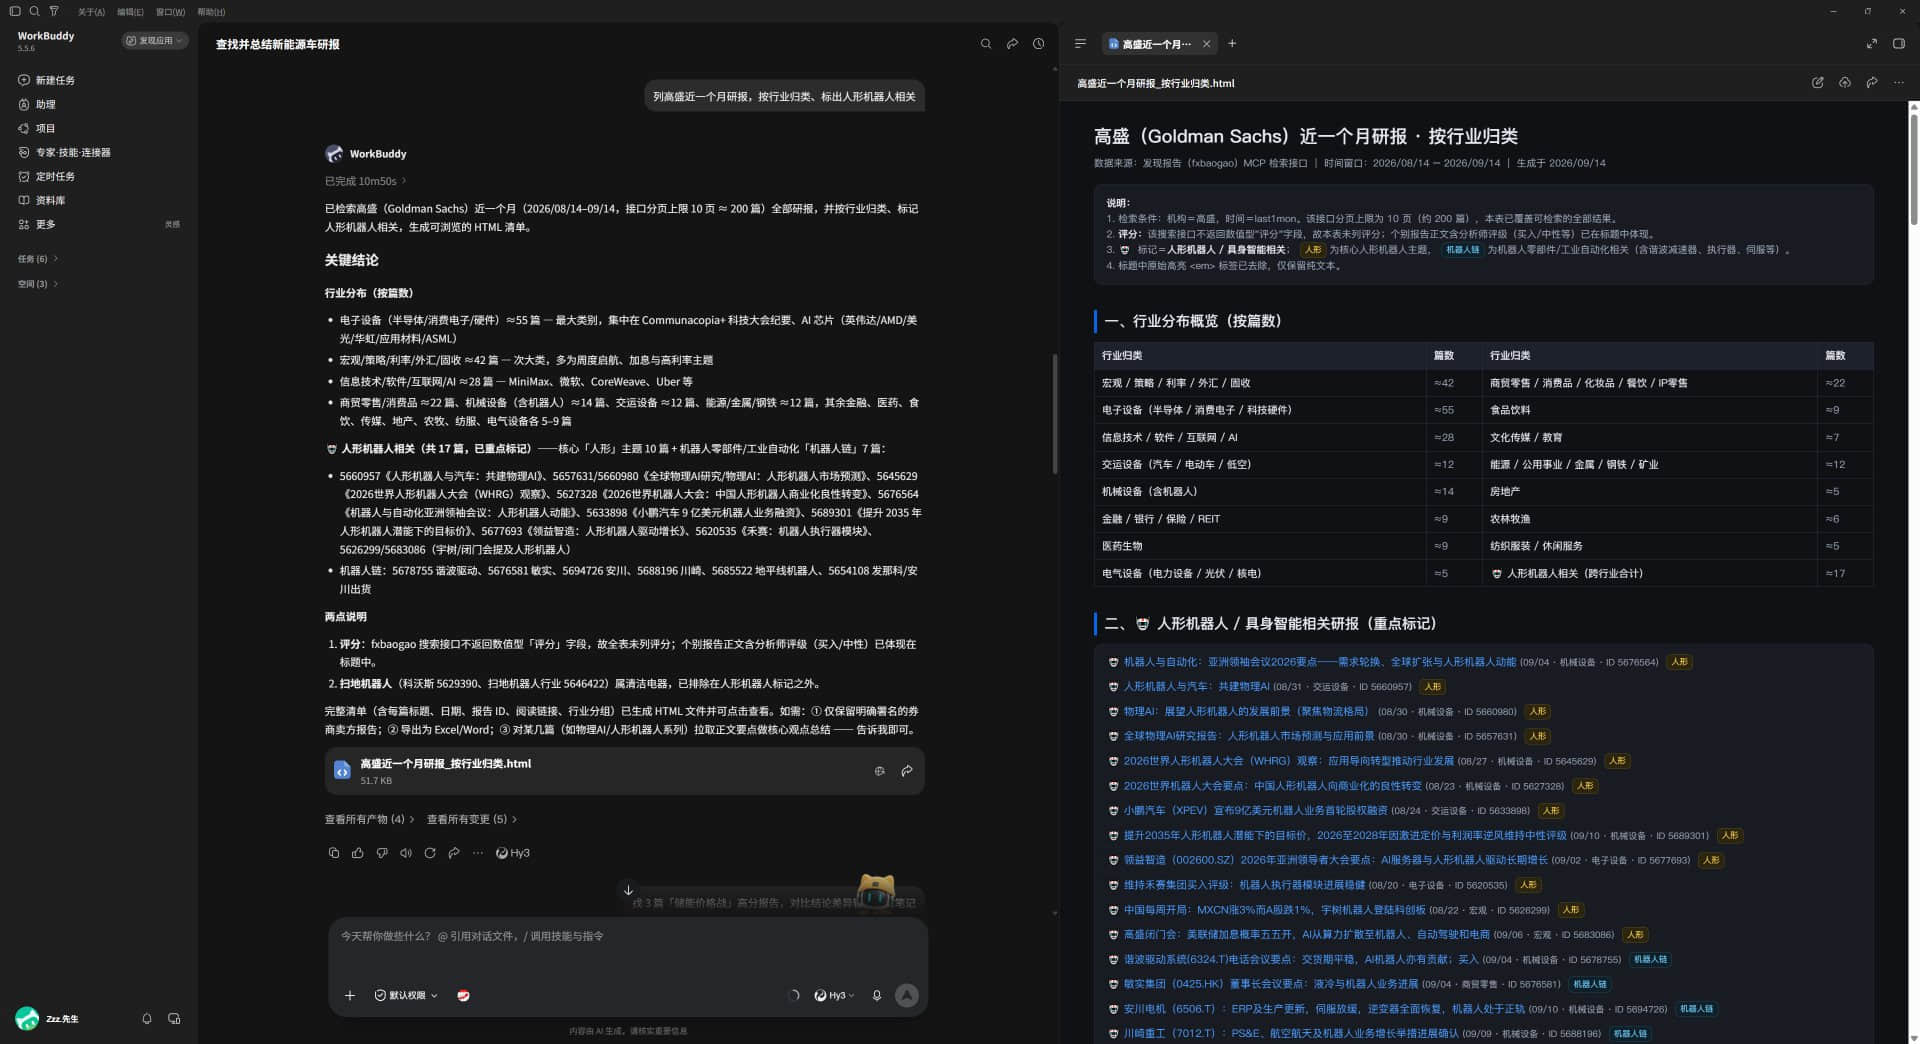
「检索高盛近一个月研报,按行业归类,标出人形机器人相关。」
调用:search_reports · 把机构名 / 公司名作为关键词,即可跟踪任何卖方观点变化
多报告对比笔记
「找 3 篇『储能价格战』高分报告,对比结论差异输出一页笔记。」
调用:search_reports → get_paragraphs · 不用读全文,直接基于命中段落产出对比结论
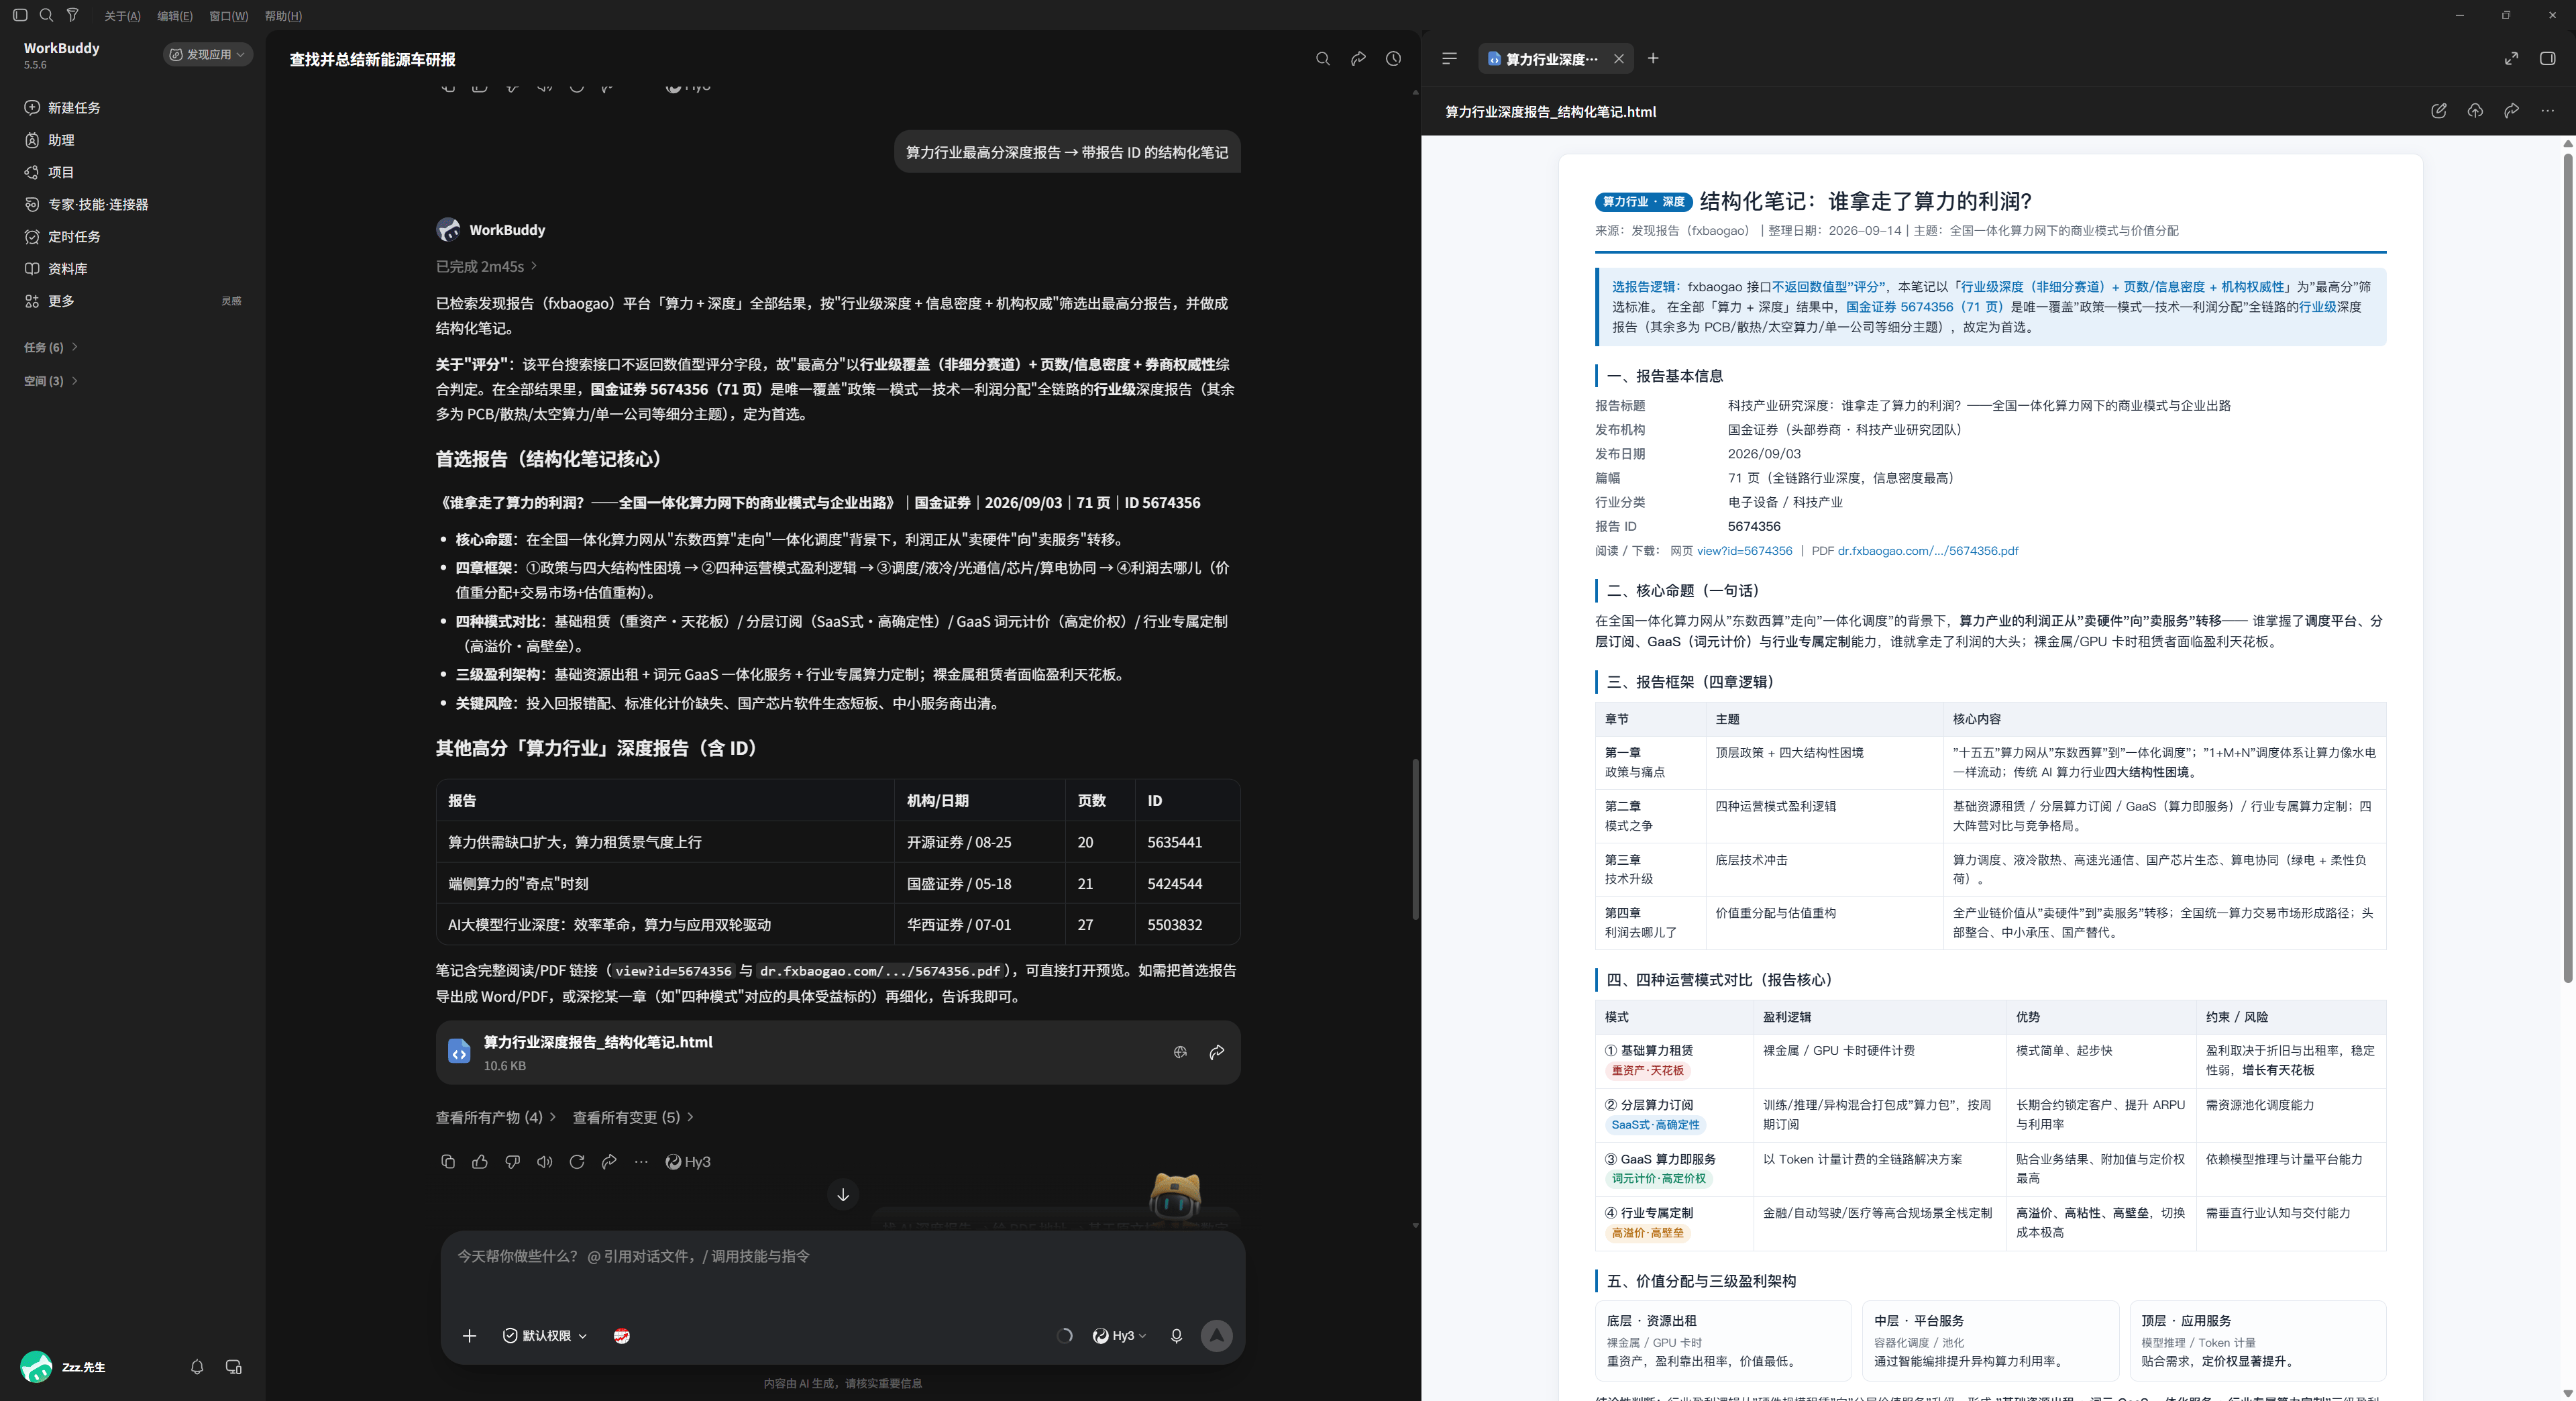
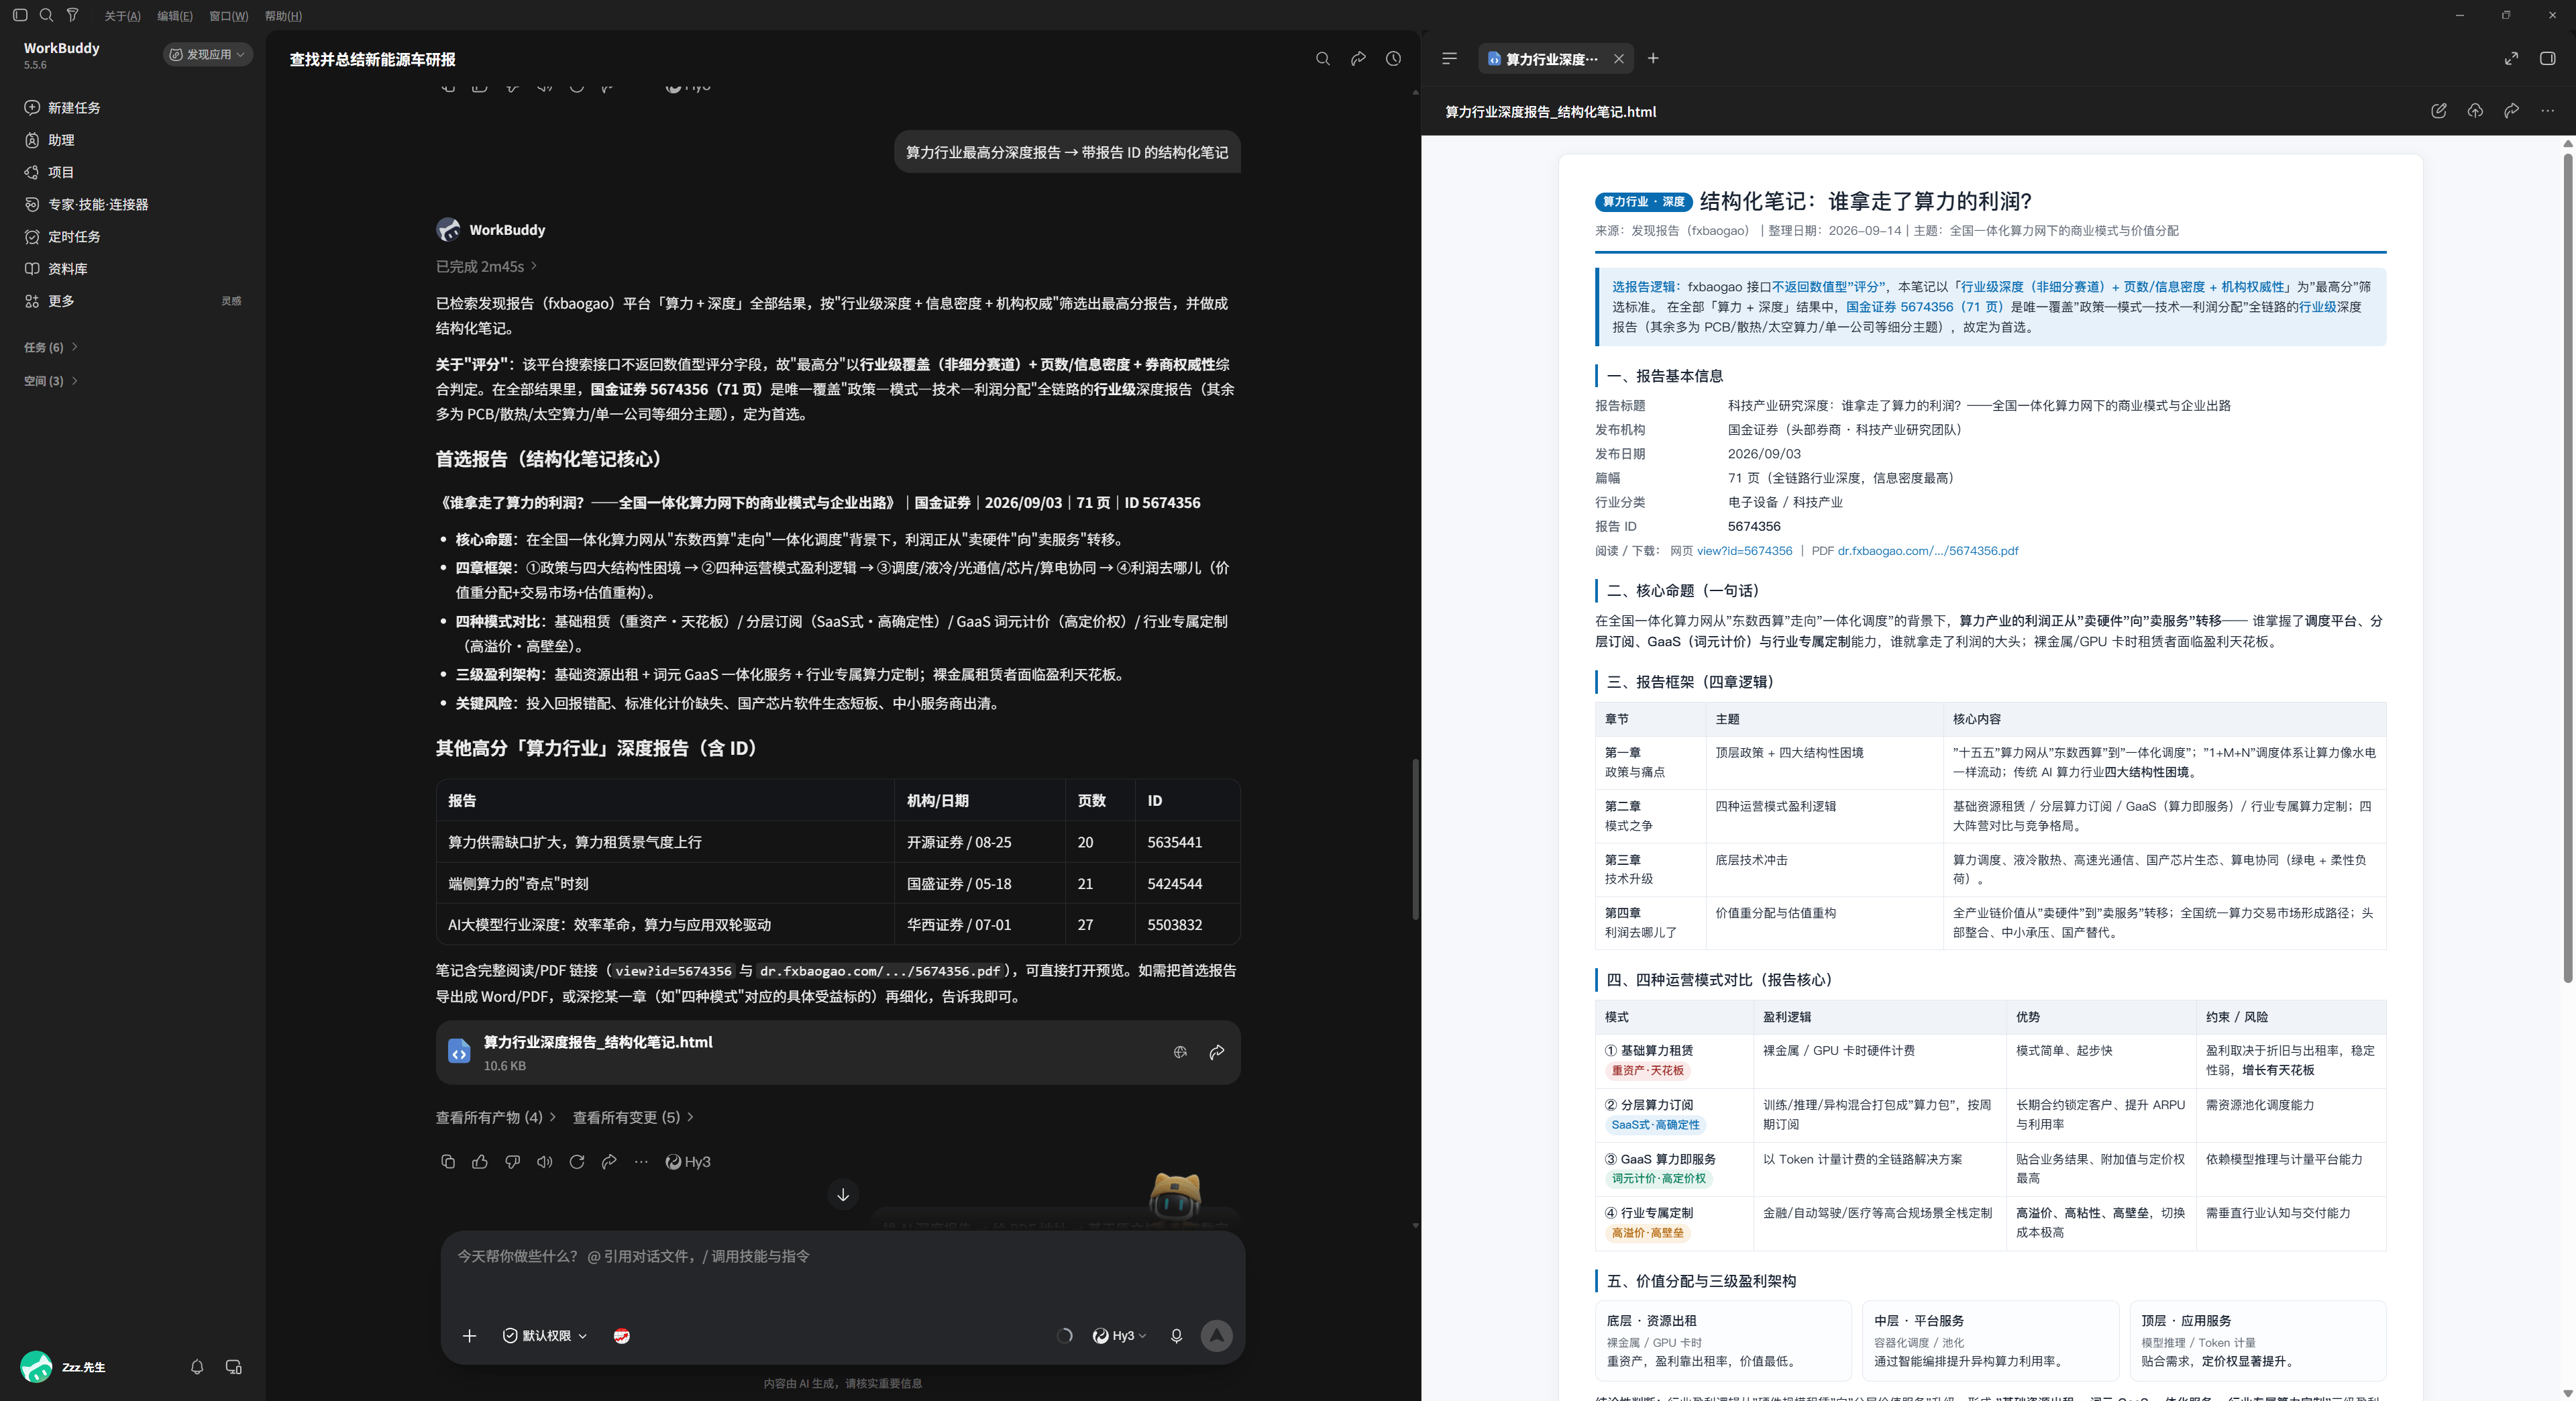
单篇深度读书笔记
「算力行业最高分深度报告,抽目录段落,产出结构化笔记。」
调用:search_reports → get_paragraphs · 产出全程保留 reportId,每个结论都能回原文核对
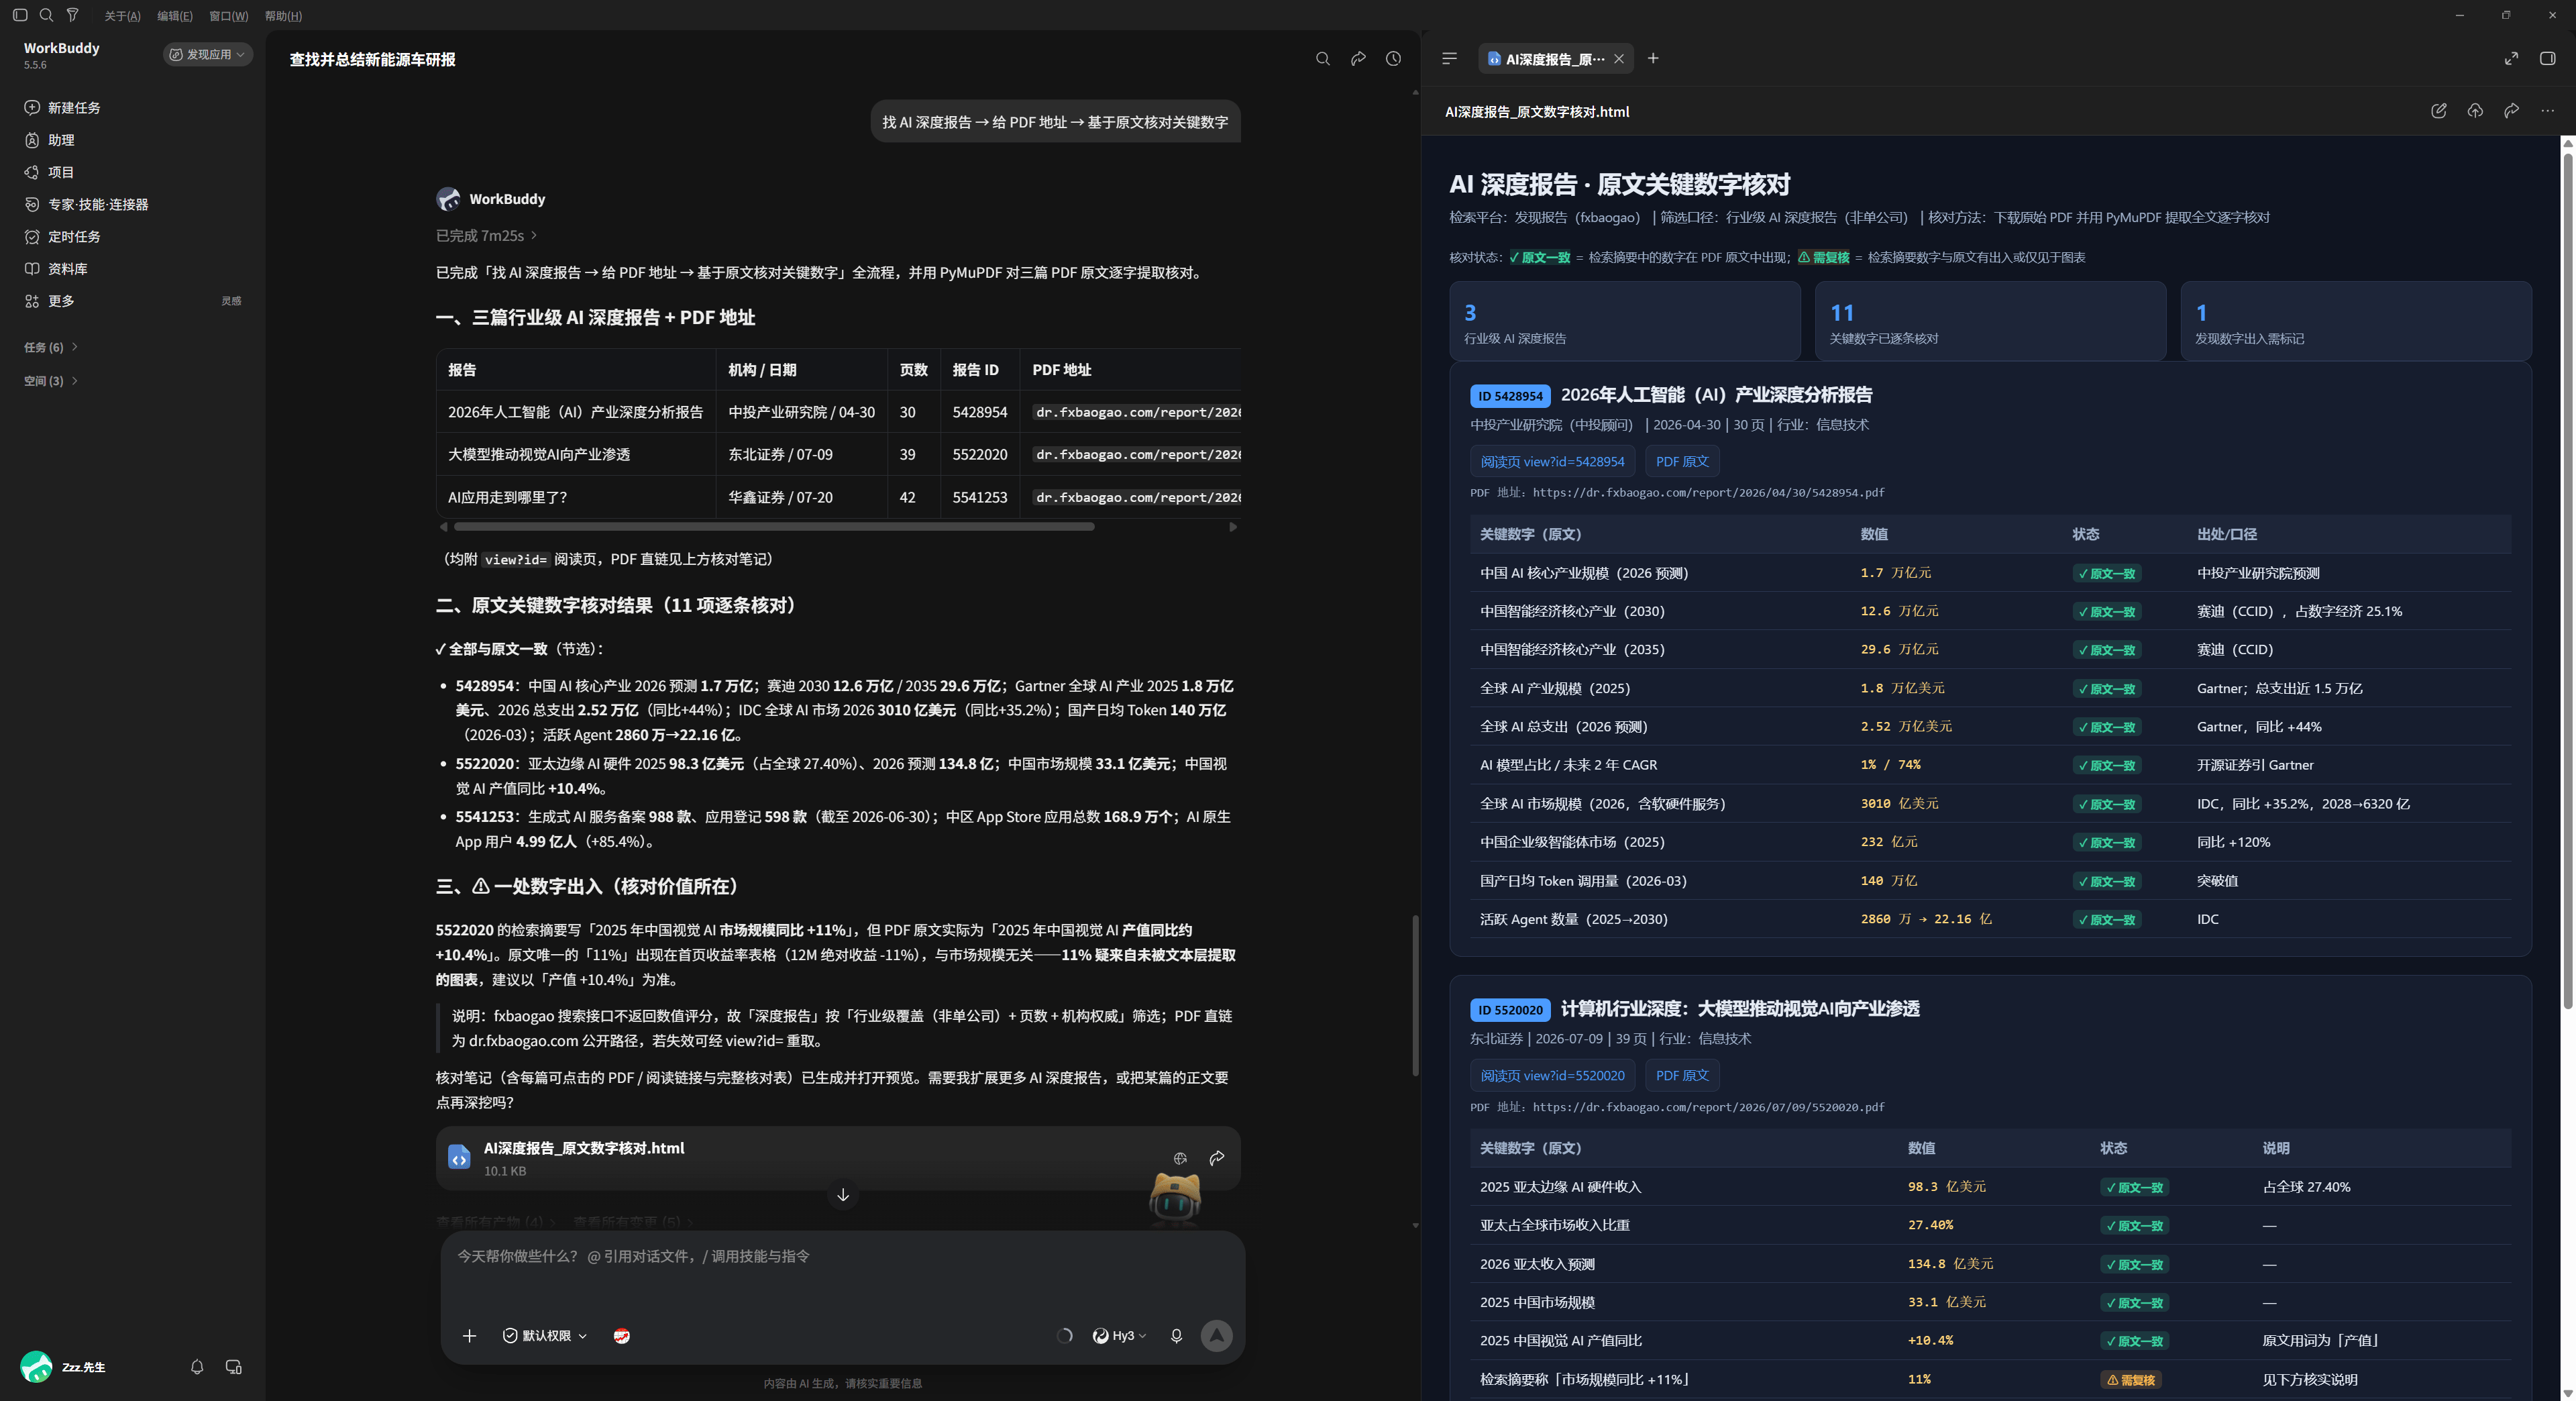
下载原文 · 关键数字核验
「找 AI 深度报告 → 给 PDF 地址 → 基于原文核对关键数字。」
调用:search_reports → get_paragraphs → get_pdf_url · 正式研究与引用前用这条;下载 PDF 会扣减下载权益,按需使用
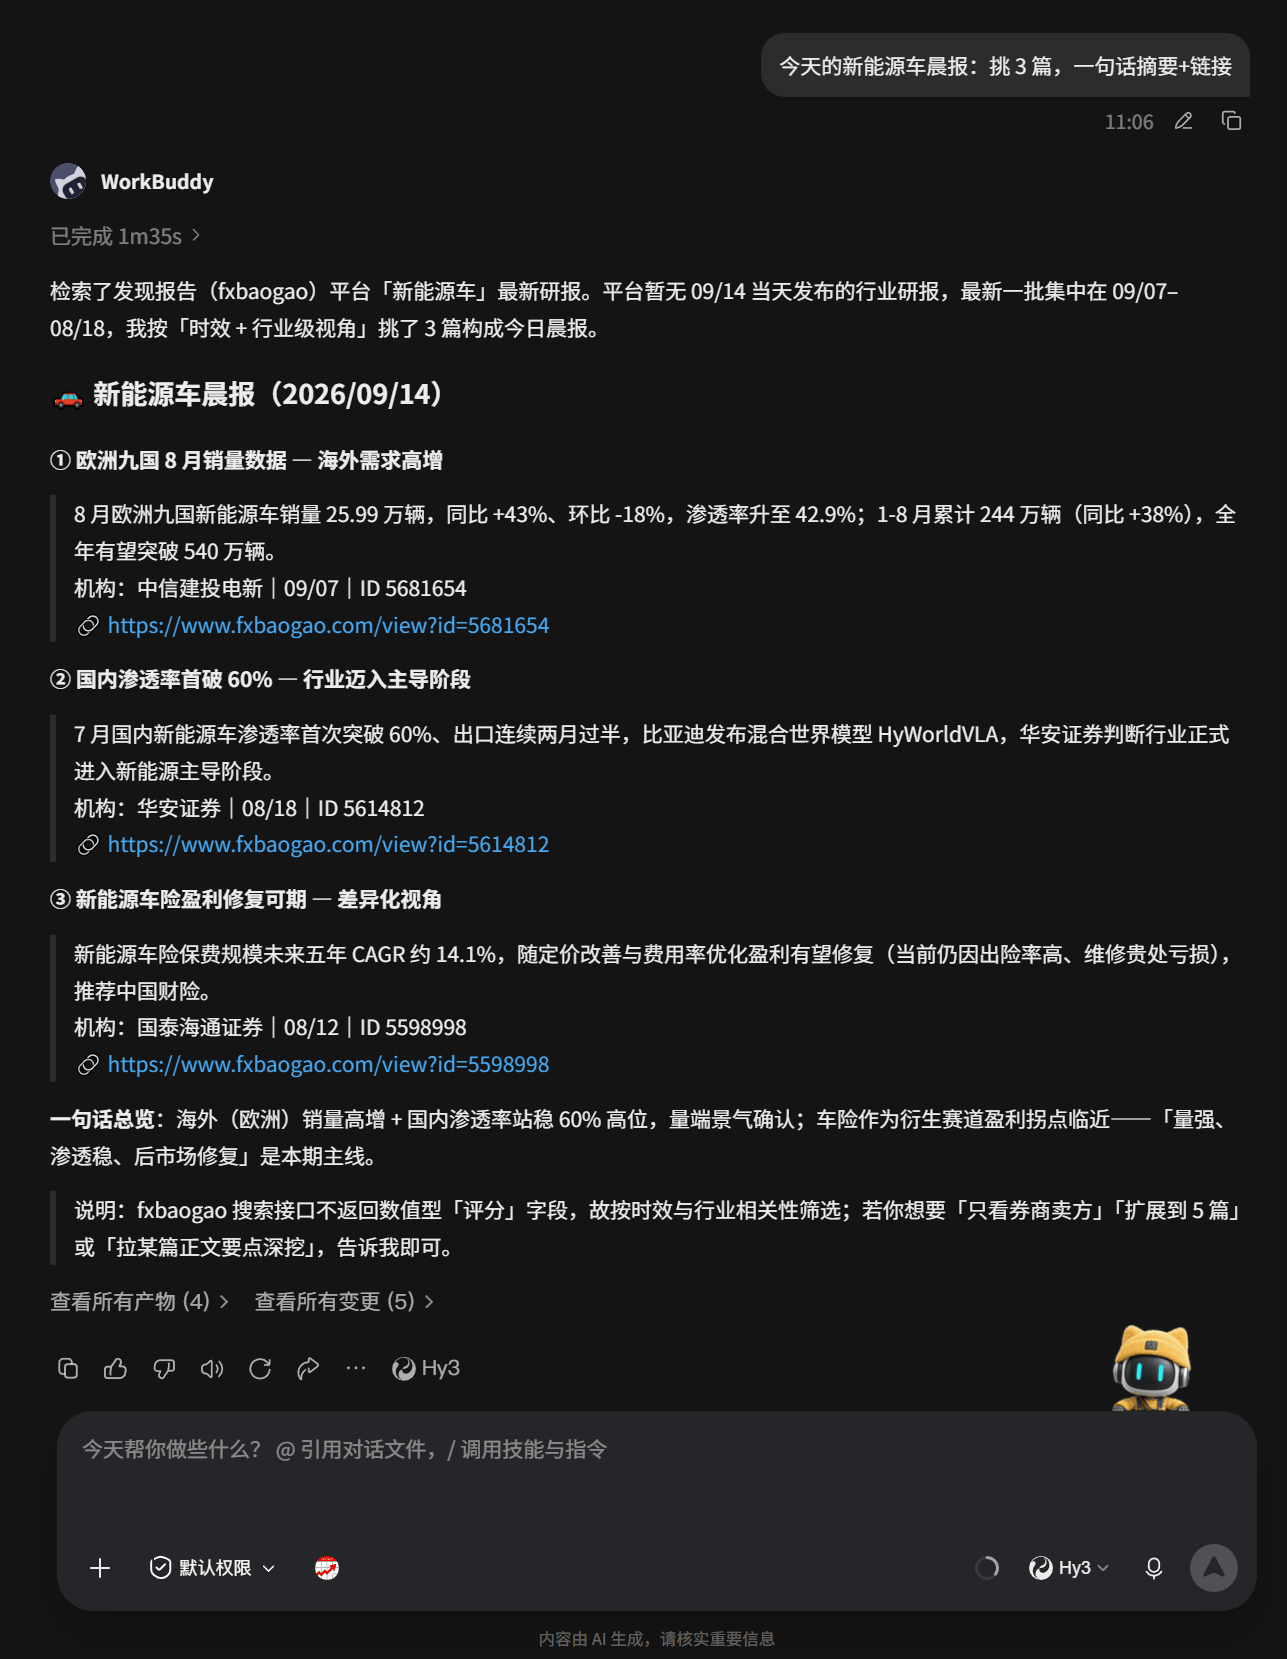
每日研报晨报
「今天的新能源车晨报:挑 3 篇,一句话摘要+链接。」
调用:按需组合三个工具 · 配合定时任务(扣子工作流 / 客户端定时对话)即可无人值守产出
提问公式:时间范围 + 行业 / 机构 / 公司 + 你要什么(列表、对比、笔记还是原文)。想要更准的召回,先拆问题再检索(见「七、使用注意事项」05 条)。
案例二 · DeepSeek + Cherry Studio:每日行业晨报
在免费开源的桌面客户端 Cherry Studio 里,用 DeepSeek 模型驱动发现报告的检索能力,每天几分钟拿到指定行业的研报晨报。
-
1
配模型:到
platform.deepseek.com创建 API Key,在 Cherry Studio「设置 → 模型服务」找到深度求索,粘贴 Key 并点击「检查」,通过后设为默认模型; -
2
接工具:「设置 → MCP 服务器 → 添加服务器」,类型选「可流式传输的 HTTP(Streamable HTTP)」,URL 填
https://api.fxbaogao.com/mcp/,请求头填Authorization=Bearer sk-xxx(sk-xxx 换成你的发现报告 Key),保存并启用; -
3
验连接:展开服务详情,能看到
search_reports、get_paragraphs等工具即接入成功; - 4 开始用:回到对话界面,开启 MCP 调用开关,输入下面的指令即可。
指令示例:「检索最近三天(last3day)半导体行业新增研报,按机构列出标题与发布日期,再挑 3 篇最重要的给出核心观点。」模型会先调用 search_reports 完成检索,再按需用 get_paragraphs 摘取命中段落,最后汇总成一页晨报。
注意:DeepSeek 官方网页版与 App 不开放 MCP 配置入口 —— 这不是缺功能,而是 MCP 属于客户端能力。模型经 API Key 参与对话,工具由客户端接入。
案例三 · 通义千问 Qwen-Agent:深度研报精读
Qwen-Agent 是阿里开源的 Agent 框架,内置 MCP 客户端。适合把「检索 → 精读 → 产出」串成一条可复核的多步研究流水线。
- 1 装框架:按 Qwen-Agent 官方文档安装框架(含 MCP 支持),模型选用通义千问系列,API Key 从阿里云百炼平台获取;
-
2
登记服务:在框架的
mcpServers配置字段登记fxbaogao服务,url与headers与上方在线版 JSON 完全一致; -
3
下任务:一句话下达多步指令:「找到近一周(
last7day)评分最高的储能行业报告,抽取目录与命中段落,生成结构化读书笔记。」框架会按检索、精读、产出的顺序依次调用工具; -
4
可回查:产出的读书笔记全程保留
reportId与官网阅读链接https://www.fxbaogao.com/view?id=<reportId>,每个结论都能回到原文核对。
自研接入时建议沿用「先拆问题、再检索」的方法(见「七、使用注意事项」05 条),否则召回质量会明显下降。
案例四 · 扣子 Coze 工作流:自动化监控与推送
用扣子(Coze)的 HTTP 工具节点封装检索接口,搭一条「定时检索 → 格式化 → 推送群机器人」的自动化流水线,实现无人值守的行业研报监控。
-
1
建工作流:登录
www.coze.cn创建工作流,添加「HTTP 请求」节点,按第三章接口表填写POST /mofoun/agent/search与 Authorization 请求头; -
2
定参数:请求体填
keyword(行业或机构名)、startTime(如last1day/last3day)、pageNum(≤10)等参数; - 3 接推送:后接「飞书 / 企业微信机器人」节点,把返回结果格式化为「标题 + 机构 + 阅读链接」的消息卡片;
- 4 定时跑:把工作流发布为定时任务(如每个交易日 8:00),团队每天在群里直接收到新增研报速览。
各模型客户端对 MCP 传输方式(HTTP / SSE / stdio)、可挂载工具数量与上下文长度的支持不同,接入前请先确认所用平台的能力边界;模型对 MCP 的实际调用效果与所选模型的工具调用能力有关,建议优先使用各家的主力型号。AI 基于接口数据生成的内容由使用方自行负责,平台仅提供数据检索与接口调用能力。
七使用注意事项
- 01 API Key 是唯一凭证:三种接入方式共用同一个 Key,请勿泄露、勿提交到代码仓库或截图外发;一旦怀疑泄露,请及时联系商务更换。
- 02 下载会扣减权益:通过接口拉取的报告 PDF 会同步扣取发现报告下载权益数量,请按需调用,避免无意义的批量拉取。
- 03 paragraph 与 PDF 要分场景使用:段落回包适合快速初筛和轻量研究;正式研究、原文引用和关键数据核验,必须下载 PDF 并基于原文核对。
-
04
保留报告 ID 与阅读链接:所有平台资料都应保留
reportId与官网阅读链接https://www.fxbaogao.com/view?id=<reportId>,便于回查与引用。 - 05 先拆问题,再检索:调用搜索接口前先产出研究边界与 MECE 子问题矩阵。Skills 已内置该约束,自研接入时建议沿用同一方法,否则召回质量会明显下降。
-
06
善用时间快捷参数:
startTime支持last3day、last7day、last1mon、last3mon、last1year,无需自行换算时间戳。 -
07
搜索结果分页上限为 10 页:
pageNum取值范围 1–10,超过范围需调整检索条件而非翻页。 - 08 数据边界:接口提供的是账号授权范围内的研报资源,请遵守发现报告的使用条款与相关法律法规,勿用于未授权用途。
- 09 内容性质:接口返回的是研报原文数据,不含 AI 生成内容,仅供研究参考,不构成投资建议。
八总结
通过发现报告的 AI 接入能力,我们重构了研究员与研报数据之间的交互方式。过去,研究员在多个站点间反复切换、手工拼接信息的场景,将成为历史。如今,同一套能力、三种调用方式,让 610 万+ 研报与 4,800 万+ 图表数据直接进入 AI 的工作流 —— 研究工作的重心从「找数据」真正回归到了「想问题」。
MCP 与 Skill 作为 AI 时代的「万能插座」,不仅解决了数据分散和工具割裂的长期痛点,更打开了一扇门:当 AI 能够精准检索结构化研报、命中原文段落、下载并核对 PDF 时,研究的深度和效率将被提升到一个前所未有的水平。无论是买方、卖方的专业研究员,还是希望在 AI 工作流中接入研报数据的团队,发现报告都将有望成为您最得力的「研报数据与分析后端」。
我们相信,未来的研究工作不是 AI 替代研究员,而是研究员 + AI + 专业数据的协同进化。我们希望,发现报告的 AI 接入能力,能成为这场进化中可被随时调用的那层基础设施。
立即接入,让你的研究流程跑在 AI 的工作流里。
九常见问题解答
以下 12 个问题来自接入过程中最高频的疑问,答案均出自本文正文,可直接对照查阅。
发现报告的 AI 接入是什么?
发现报告把 610 万+ 研报与 4,800 万+ 图表数据资产,封装成 Skills、CLI、MCP 三种标准化接入方式。三种方式底层调用的是同一套能力 —— 报告搜索、段落精读、PDF 下载,区别只在于谁来调用。
三种接入方式有什么区别,我该选哪一种?
Skills 面向研究员,用自然语言触发,适配 Codex 与 Claude;CLI 面向开发者,终端一条命令完成搜索、阅读、下载,支持批量处理、脚本编排、CI/CD 与定时任务;MCP 面向 AI Agent,让 WorkBuddy、Claude Desktop、Cursor 等客户端直接调用,在线版零安装,本地版一键启动。
接入需要什么前置条件?
只有一步:开通高级 VIP 获取 API Key。开通入口为 www.fxbaogao.com/user,获取 API Key 的入口为 www.fxbaogao.com/user/userInfo;配置环境变量 FXBAOGAO_API_KEY 后,三种方式即可立即使用。
一个 API Key 能用于三种接入方式吗?
可以。三种接入方式共用同一个 API Key。它是唯一凭证,请勿泄露、勿提交到代码仓库或截图外发;一旦怀疑泄露,请及时联系商务更换。
底层提供哪些接口?
Base URL 为 https://api.fxbaogao.com,鉴权头为 Authorization: Bearer <API Key>。报告搜索为 POST /mofoun/agent/search,段落精读为 POST /mofoun/agent/paragraph,取 PDF 地址与下载为 GET /mofoun/agent/download。
MCP 提供了哪几个工具?
三个:search_reports(按关键词、机构、时间范围搜索研报)、get_paragraphs(获取摘要、目录与正文命中段落)、get_pdf_url(获取 PDF 地址)。三个工具形成「搜索 → 精读 → 取地址」的完整链路;需要把 PDF 下载到本地时,配合 CLI 的 fxbaogao download 即可。
时间范围支持哪些快捷写法?
支持 last3day、last7day、last1mon、last3mon、last1year,无需自行换算时间戳;也可以直接传毫秒时间戳字符串。
搜索结果能翻多少页?
分页上限为 10 页,pageNum 取值范围 1–10。超出范围时需要调整检索条件,而不是继续翻页。
下载 PDF 会消耗额度吗?
会。通过接口拉取的报告 PDF 会同步扣取发现报告下载权益数量,请按需调用,避免无意义的批量拉取。
paragraph 接口和下载 PDF 该怎么选?
段落回包适合快速初筛和轻量研究;正式研究、原文引用和关键数据核验,必须下载 PDF 并基于原文核对。
引用研报时怎么保留回查线索?
所有平台资料都应保留 reportId 与官网阅读链接 https://www.fxbaogao.com/view?id=<reportId>,便于回查与引用。search_reports 的返回结果会自动补充该链接。
使用上有哪些合规与风险边界?
接口提供的是账号授权范围内的研报资源,请遵守发现报告的使用条款与相关法律法规,勿用于未授权用途。接口返回的是研报原文数据,不含 AI 生成内容,仅供研究参考,不构成任何投资建议、买卖推荐或操作指令。
没找到答案? 可前往 获取 API Key 页面联系商务,或查阅 GitHub 仓库 中的完整文档说明。